
Bug tracker issue #229
-
@victor said in Bug tracker issue #229:
- Ошибка в заголовке и теле письма
Описание: не все макросы заполняются данными, и поэтому нарушается подстановка
Шаблон почтового извещения полностью аналогичен предыдущему.
Используемый Event (Message template): Агент NetXMS не отвечает
получаю сообщение:
Subject: Minor (11-Jul-2008 20:01:06): параметр "" на сервере test3.server.ru
ВРЕМЯ ВОЗНИКНОВЕНИЯ: 11-Jul-2008 20:01:06
МЕСТО ВОЗНИКНОВЕНИЯ: test3.server.ru[10.100.143.162]
ИСТОЧНИК СОБЫТИЯ:
СТАТУС СОБЫТИЯ: MinorАгент NetXMS не отвечает
Нельзя ли хоть чем-нибудь заполнять Event Source? Или это ошибка?
Makrosi %1 .. %9 - eto parametri sobitija. Kolichestvo i znachenie parametrov zavisit ot koda (tipa) sobitija. U sobitija SYS_AGENT_UNREACHABLE net parametrov, poetomu makros %2 raskrivaetsja v pustuju stroku.
Variantov reshenija dva - libo delat' raznie e-mail templeiti dlja raznih tipov sobitij, libo formirovat' zelaemij tekst pri pomoschi scripta.
- Ошибка в заголовке и теле письма
-
-
и вдогонку ещё одна найденная мной сегодня ошибка, походу всё из той же оперы:
опять использованы все те же настройки как написано ранее в теме (отличие есть, мереем не температуру а дисковое пространство, но это различие совершенно не значительно).
что имеем: при обработке события со статусом Critical не обрабатывается макрос, подставляющий текущее полученное DCI значение (Текущее значение:).
примечание: и в Alarm Browser'е та же ситуация: нет текущих значений.
т.е. как мы можем наблюдать, эталонное значение (с которым сравниваем) есть - 5.000000, а вот то, которое получаем и которое сравниваем- нет. не подставляется.
и это только в случае с Severity = Critical.
Event configuration:
Name: DISK_CAPACITY_CRITICAL
Message template: АХТУНГ: критическое состояние параметра "%2"! Текущее значение: %4 (допустимое значение: %3)
Severity = Critical (write to Event Log)ВРЕМЯ ВОЗНИКНОВЕНИЯ: 21-Jul-2008 10:25:45
МЕСТО ВОЗНИКНОВЕНИЯ: test.server.ru[10.100.1.11]
ИСТОЧНИК СОБЫТИЯ: Свободное место на диске (в %)
СТАТУС СОБЫТИЯ: CriticalАХТУНГ: критическое состояние параметра "Свободное место на диске
(в %)"! Текущее значение: (допустимое значение: 5.000000)у меня на нескольких серверах в выходные начало кончаться место. ВСЕ сообщения с severity = Critical, полученные от всех серверов за 2 выходных дня, не содержат текущих данных по свободному объёму диска.
т.е. ошибка не единичная, подстановка не работает в принципе.
И есть подозрение что данные по текущему показателю ПРИ Severity = Critical вообще не попадают в базу и дальнейшая обработка приостанавливается (на серверах со временем место пришло в норму, но статус Critical с DCI дисков не снялся).
- ВОПРОС: применительно к мониторингу ресурсов и степени их занятости (заполненности).
Если используется несколько степеней важности (Warning, Minor, Major, Critical) загруженности ресурса, КАК можно указывать автоматом (через макрос) применительно к указанным выше шаблонам текста, что для всех степеней важности Эталонное пороговое значение (Threshold) - своё (понятно, что для каждого статуса - отдельное), а вот при подстановке в текст нужно иметь ввиду, что ОБЩЕЕ эталонное значение- отдельное и для всех одинаковое (нужно брать из статуса Normal)?
объясню:
сободно на диске (Threshold Condition) => 10 гб - Normal
при Threshold Condition =< 9 гб = Warning
при Threshold Condition =< 8 гб = Minor
при Threshold Condition =< 7 гб = Major
при Threshold Condition =< 6 гб = CriticalСоответственно Threshold Condition для каждого Threshold - свой. Но суть в том, что для всех них есть один единый ЛОГИЧЕСКИЙ Threshold, 10 гб. Который определяет НОРМАЛЬНОЕ состояние диска.
Было бы совсем неплохо иметь возможность размер этого базового Threshold подставить в текст... А то получается что в текст сейчас можно подставить только Текущий показатель и его эталонный Threshold.
вопрос возник потому, что у меня используется несколько разных схем мониторинга дисков, где-то - в %, где-то - в абсолютных величинах, при этом к разным серверам - разные требования (у сервером сильно различается объём дисков). а добиться хочется максимальной универсализации...
-
Обновление по предыдущему посту: похоже что это одна и та же ошибка.. не другая... или не совсем другая....
я перезапустил Агента на сервере, с которого не мог получить данные по диску.
теперь результат есть, но он такой же, как и в случае с температурами:по некоторым дискам нормальный ответ
ВРЕМЯ ВОЗНИКНОВЕНИЯ: 21-Jul-2008 16:25:51
МЕСТО ВОЗНИКНОВЕНИЯ: test.server.ru[10.150.16.11]
ИСТОЧНИК СОБЫТИЯ: Свободное место на диске S: (в %)
СТАТУС СОБЫТИЯ: MajorОПАСНО: опасное превышение параметра "Свободное место на диске S: (в %)"! Текущее значение: 5.006286 (пороговое значение: 10.000000)
а по некоторым - аномальный результат
ВРЕМЯ ВОЗНИКНОВЕНИЯ: 21-Jul-2008 16:25:51
МЕСТО ВОЗНИКНОВЕНИЯ: test.server.ru[10.150.16.11]
ИСТОЧНИК СОБЫТИЯ: Свободное место на диске T: (в %)
СТАТУС СОБЫТИЯ: MajorОПАСНО: опасное превышение параметра "Свободное место на диске T: (в %)"! Текущее значение: (пороговое значение: 0x0000077C)
-
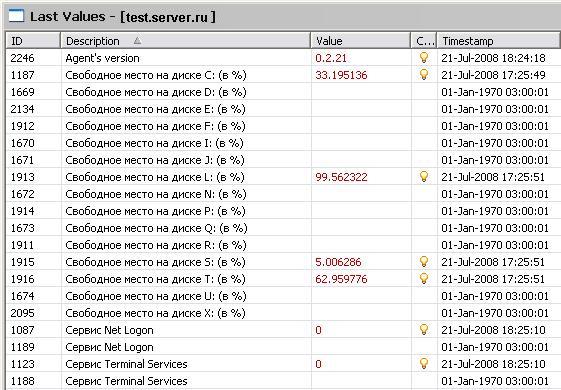
Дополнительный вопрос: а в Last Values данные показываются правильно? А то у меня есть подозрение что в момент отсылки таких писем сервер получает от агента пустую строку вместо данных и честно ее подставляет...
-
@anth0ny said in Bug tracker issue #229:
- ВОПРОС: применительно к мониторингу ресурсов и степени их занятости (заполненности).
Если используется несколько степеней важности (Warning, Minor, Major, Critical) загруженности ресурса, КАК можно указывать автоматом (через макрос) применительно к указанным выше шаблонам текста, что для всех степеней важности Эталонное пороговое значение (Threshold) - своё (понятно, что для каждого статуса - отдельное), а вот при подстановке в текст нужно иметь ввиду, что ОБЩЕЕ эталонное значение- отдельное и для всех одинаковое (нужно брать из статуса Normal)?
объясню:
сободно на диске (Threshold Condition) => 10 гб - Normal
при Threshold Condition =< 9 гб = Warning
при Threshold Condition =< 8 гб = Minor
при Threshold Condition =< 7 гб = Major
при Threshold Condition =< 6 гб = CriticalСоответственно Threshold Condition для каждого Threshold - свой. Но суть в том, что для всех них есть один единый ЛОГИЧЕСКИЙ Threshold, 10 гб. Который определяет НОРМАЛЬНОЕ состояние диска.
Было бы совсем неплохо иметь возможность размер этого базового Threshold подставить в текст... А то получается что в текст сейчас можно подставить только Текущий показатель и его эталонный Threshold.
вопрос возник потому, что у меня используется несколько разных схем мониторинга дисков, где-то - в %, где-то - в абсолютных величинах, при этом к разным серверам - разные требования (у сервером сильно различается объём дисков). а добиться хочется максимальной универсализации...
Это будет возможно начиная с версии 0.2.22 - там появится возможность делать custom attributes для объектов и иметь к ним доступ через скрипты.
Тогда можно будет сделать так:- добавить атрибут, скажем, disk_threshold_с
- при создании сообщения использовать макрос, например, %[print_disk_threshold]
- сделать скрипт print_disk_threshold:
GetCustomAttribute($node, "disk_threshold_" . $6)В instance для DCI нужно будет указывать правильное имя диска, и все.
-
@victor said in Bug tracker issue #229:
Дополнительный вопрос: а в Last Values данные показываются правильно? А то у меня есть подозрение что в момент отсылки таких писем сервер получает от агента пустую строку вместо данных и честно ее подставляет...
ээ... да вроде всё выглядит корректно... за исключением статуса.
я уже ничего не понимаю: по непонятной причине Агент (или сервер??) помечает нормальные диски как будто на них кончается место... думал - глюк, сбросил состояние... а оно вновь и вновь выставляется... я не могу понять в чём дело =((.цифры вроде правильные в Last DCI Values, а вот в ALARM'ах...
данные получены, вот, судите сами: (даю скрины)
-
Mozno esche prislat' skrinshoti s konfiguraciej thresholdov dlja problemnih DCI i istoriju sobrannih dannih za period pered vozniknoveniem problemnogo alarma? Dannie mozno cherez export poluchit' v tekstovij fail.
-
??? я уже решительно не понимаю что происходит...
за ночь проблема рассосалась сама собой: после сегодняшнего утреннего сброса статуса "Critical" с дисков сервера, теперь как "Critical" помечается только тот диск, на котором и правда реально есть проблема с местом... и ничего дурацкого... но ведь вчера-то помечались все, Вы же видели скрины... я это не придумал...сейчас: в Alarm'ах всё корректно, извещения приходят только по реально проблемным дискам.
мда. дела.склоняюсь к мысли, что чудил Агент.
так что проблема конечно есть, вот только где она зарыта....вот интересные данные для размышления:
- запрошенная история полученных значений выглядит странно, см. атач export_c.txt, я как-то сразу и не догадался туда заглянуть... даю данные экспорта только по одному диску, так как при ближайшем рассмотрении все остальные ЯКОБЫ проблемные DCI тоже получали 0 вместо реальных цифр...
я про это: https://www.netxms.org/forum/index.php?action=dlattach;topic=422.0;attach=137;image
- по поводу настроек DCI: я практически закончил руководство и даю фрагмент, относящийся именно к указанному случаю (я всё ещё жду от Вас ответ на приват, там был запрос на несколько примеров, прошу по возможности помочь :)).
Пример: создаём 4 Пороговых значения с внутренней связью для отслеживания перехода Объекта из одного Тревожного состояния в другое и возврата в Нормальное состояние (каждое Пороговое значение вводится как отдельный объект, т.е. имеет свои свойства).
Поле Thresholds list, кнопка Add.
- Раздел "Condition" (Условие)
Пункты "will be" и "than" - условия для проведения Сравнения получаемых Сборщиком и Пороговых эталонных данных
Примечание: указан не порядок ввода, а порядок окончательного положения Порогов в списке Thresholds list; пункты с 1) по 4) - 4 повторяющихся действия по созданию каждого Порога отдельно, которые нужно выполнить как 1)->1)[а-б]->1), 2)->2)[а-б]->2) и т.д. до 4)
Вводим данные:
- will be less than 5.000000
- will be less than 10.000000
- will be less than 15.000000
- will be less than 20.000000
- Раздел "Event" (Событите)
Пункт а) "If condition is TRUE, generate the following event"
Пункт б) "When condition becames FALSE again, generate the following event"
Вводим данные:
- а) DISK_CAPACITY_CRITICAL б) DISK_CAPACITY_MAJOR
- а) DISK_CAPACITY_MAJOR б) DISK_CAPACITY_MINOR
- а) DISK_CAPACITY_MINOR б) DISK_CAPACITY_WARNING
- а) DISK_CAPACITY_WARNING б) DISK_CAPACITY_OK
- Раздел "Repeat Event" (Повтор События)
Пункт "Every".
Вводим данные:
- 600
- 900
- 1800
- 3600
Т.е. таким образом мы постепенно переводим Объект из одного из 4ёх состояний в другое по мере заполнения (или освобождения) диска и извещения о состоянии заполнения диска чаще приходят при более критических уровнях заполнения.
-
Дополнительный вопрос: а в то время, когда шли 0 вместо нормальных значений, остальные параметры собирались?
У меня тоже обнаружился один сервер, который иногда так себя ведет - раз в неделю примерно. Похоже на проблему с агентом, но я пока-что не могу повторить ее и понять почему так происходит. -
@victor said in Bug tracker issue #229:
Дополнительный вопрос: а в то время, когда шли 0 вместо нормальных значений, остальные параметры собирались?
У меня тоже обнаружился один сервер, который иногда так себя ведет - раз в неделю примерно. Похоже на проблему с агентом, но я пока-что не могу повторить ее и понять почему так происходит.мм.. если вопрос о других собираемый с того же сервера параметрах, то я не могу на него ответить однозначно: все остальные запросы на этом сервере возвращают только 0 или 1. к тому же мониторятся не самые сбойные сервисы и они вполне могли всё время возвращать 0, даже тогда когда 0 возвращался для места на диске...
с других серверов сбор идёт ровно. без проблем.
за исключением ранее описанного бага: некорректная макросная подстановка продолжается.
ВРЕМЯ ВОЗНИКНОВЕНИЯ: 25-Jul-2008 11:59:11
МЕСТО ВОЗНИКНОВЕНИЯ: test.server.ru[10.100.12.34]
ИСТОЧНИК СОБЫТИЯ: [DL] [MB Ambient] Температура Системы
СТАТУС СОБЫТИЯ: MinorОПИСАНИЕ СОБЫТИЯ: Внимание! Превышено допустимое значение параметра "[DL] [MB Ambient 1] Температура Системы"! Текущее значение: +C (допустимо: +0x000005A7C)


Hello! It looks like you're interested in this conversation, but you don't have an account yet.
Getting fed up of having to scroll through the same posts each visit? When you register for an account, you'll always come back to exactly where you were before, and choose to be notified of new replies (either via email, or push notification). You'll also be able to save bookmarks and upvote posts to show your appreciation to other community members.
With your input, this post could be even better 💗
Register Login