
Шквал оповещений после кратковременной потери контакта с прокси нодой
-
Перечитал внимательно изначальное сообщение с логами событий - там на ноде не возникало события SYS_AGENT_UNREACHABLE, a было только SYS_NODE_UNREACHABLE - сервер понимает что из-за отсутствия прокси нода недоступна и не генерит отдельные события про агента.
Поэтому таймер не заводился и поэтому ничто не ограничивало отправку нотификации когда пришло SYS_AGENT_OK -
-
Основные события это SYS_NODE_DOWN / SYS_NODE_UNREACHABLE, а когда нода поднимается обратно то SYS_NODE_UP. Попробуйте на них настроить нотификации.
-
-
К сожалению это не помогло. Тестировал на версии 6.2.0
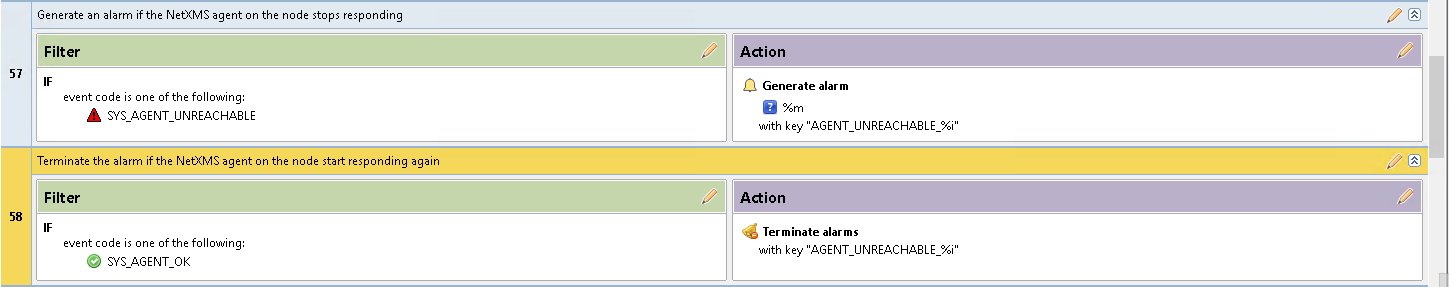
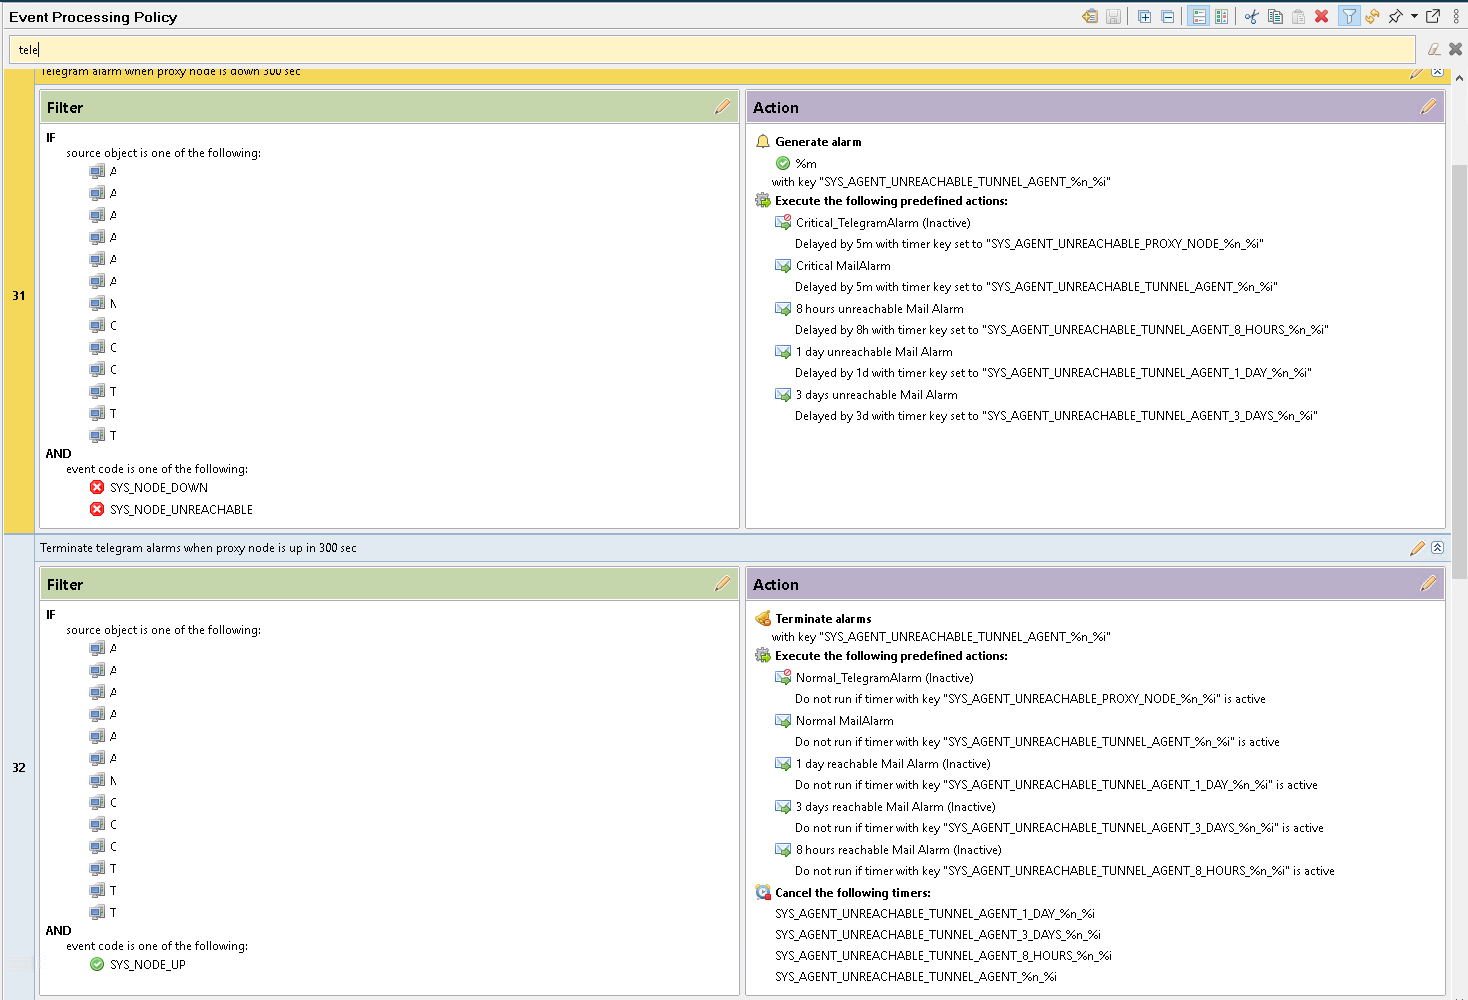
Правило уведомления для ноды за прокси
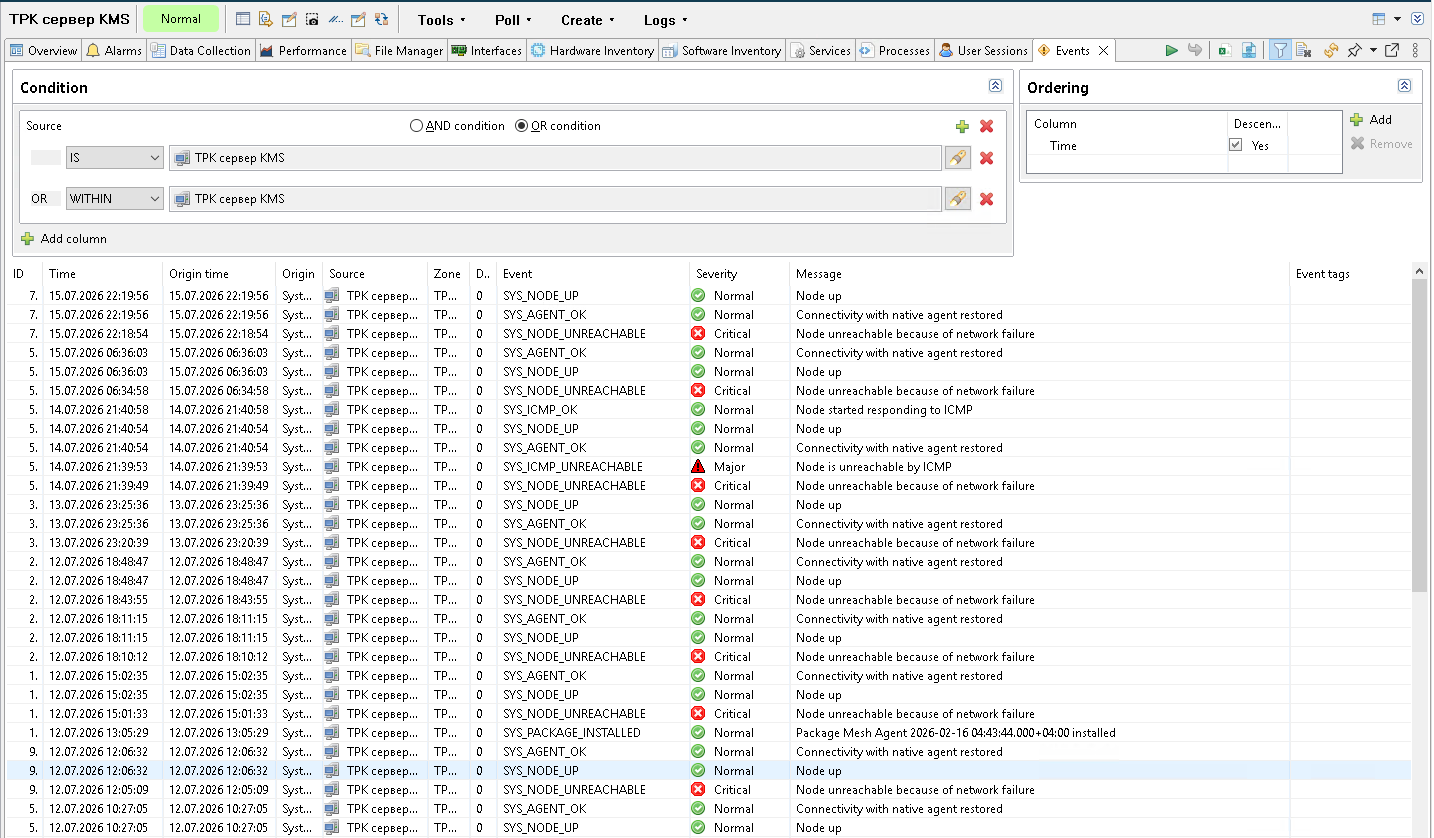
https://drive.google.com/file/d/1eUiX2z1VVnJh8BRj6kG7bmZ6xlkYg4BU/view?usp=drive_linkЛог событий от ноды за прокси
https://drive.google.com/file/d/1V0tSkzDTEGF6YIcRQHng8ONGnOegO8P6/view?usp=drive_linkСамо уведомление (хотел сделать скриншот лога уведомлений с ноды но не нашел где это в новом клиенте)
https://drive.google.com/file/d/13kLb52E32amHju2tboypZiEgeWb-Pnza/view?usp=drive_linkЕсть мысли что еще можно проверить?
-
-
-
Нет. Хуже. База начала расти постоянно. При входе в logs - alarm выдавала ошибку базы данных.
Архив тоже оказался проблемным (не сразу заметил проблемы, и с базой из архива случились те же проблемы что и с рабочей базой).
Итог: установил новый сервер на базе последней сборки netxms (6.2.1) на актуальной ubuntu server (26.04 LTS).Проблему наблюдаю ту же что изначально. Смена событий для нотификации на предложенные не помогла. Завтра постараюсь прислать скриншоты
-
-
-
Спасибо за скриншоты, картина стала понятнее. По порядку:
- Правила на SYS_AGENT_UNREACHABLE / SYS_AGENT_OK для узлов за прокси не будут работать в принципе.
Когда узел недоступен из-за прокси, сервер намеренно не генерирует SYS_AGENT_UNREACHABLE — причина недоступности уже известна, генерируется только SYS_NODE_UNREACHABLE. Но при восстановлении SYS_AGENT_OK генерируется. То есть таймер, который должен блокировать уведомление "появился в сети", никогда не создаётся. Старые телеграм-правила по SYS_AGENT_UNREACHABLE / SYS_AGENT_OK нужно отключить или убрать из них узлы за прокси — иначе они будут слать уведомления на каждый обрыв независимо от новых правил. Эту асимметрию (SYS_AGENT_OK без парного SYS_AGENT_UNREACHABLE) посмотрим на стороне сервера, возможно поправим.
- Новые правила 33/34 настроены правильно, но по логам правило 33 не срабатывает.
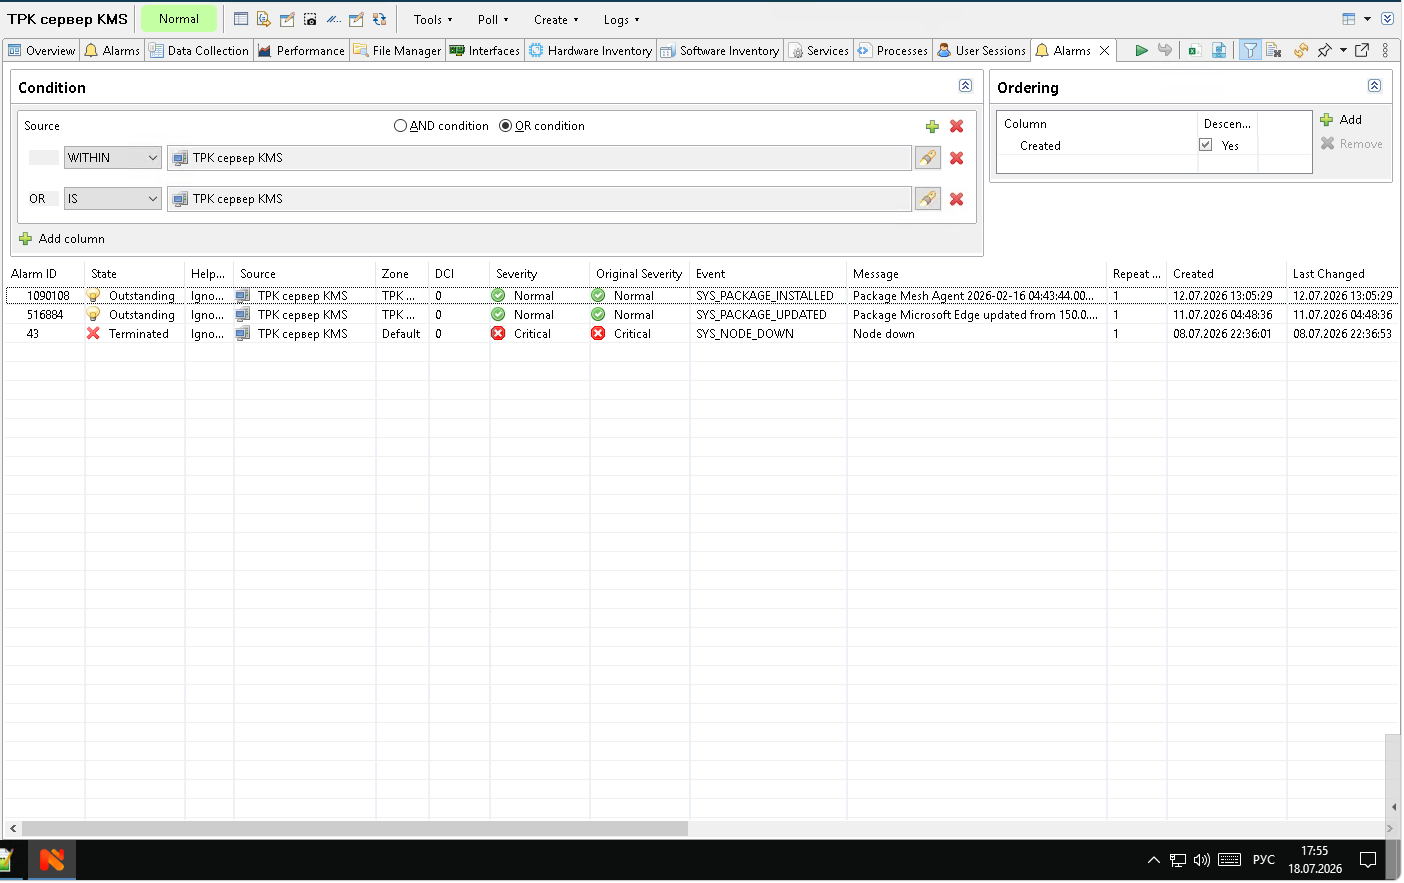
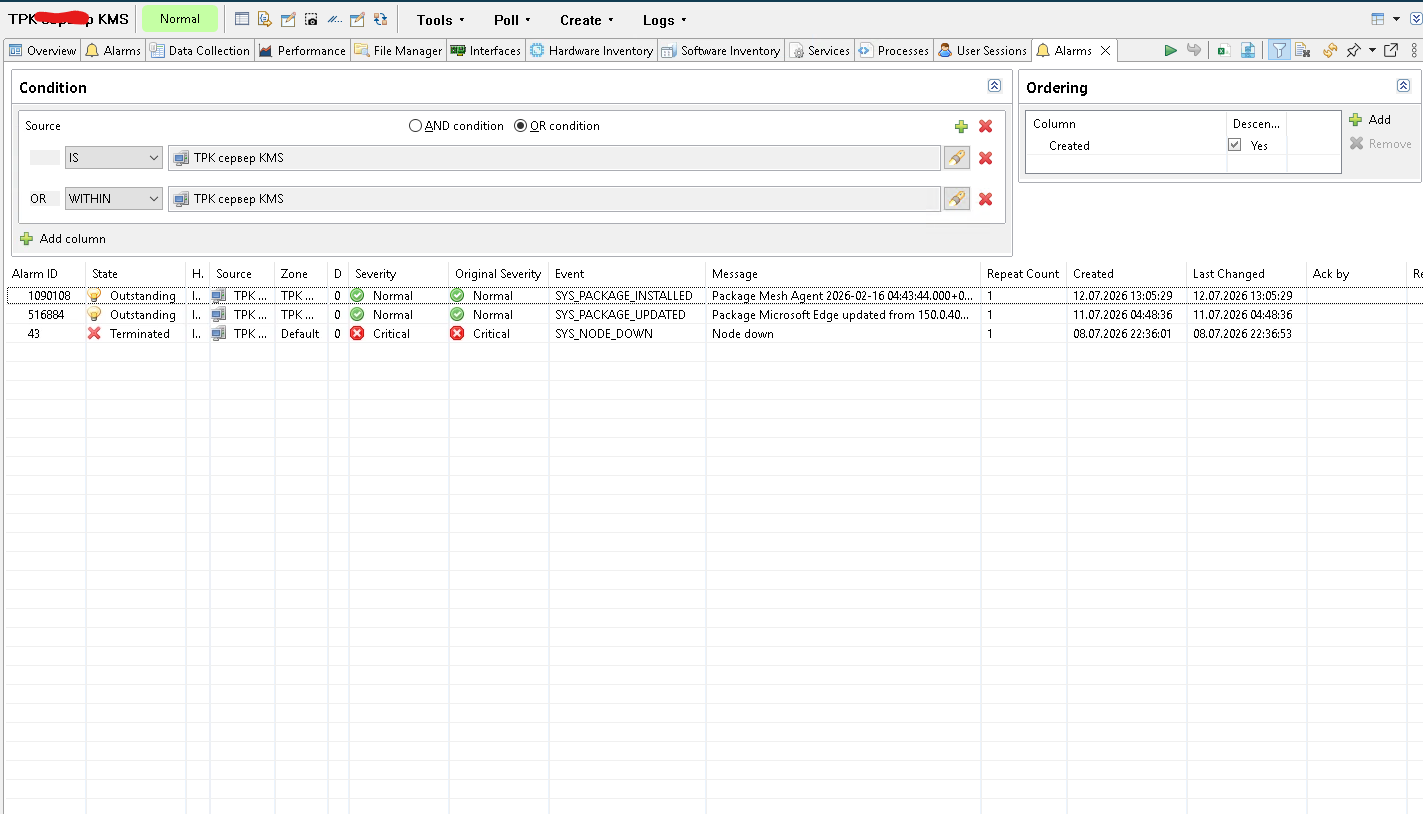
Правило 33 должно создавать аварию на каждый SYS_NODE_DOWN / SYS_NODE_UNREACHABLE. События SYS_NODE_UNREACHABLE для "ТРК сервер KMS" за 12–15.07 в логе есть, а аварий по ним нет вообще (даже завершённых — для сравнения, авария от 08.07 по SYS_NODE_DOWN есть). Раз правило не сработало — таймер не создан, и "Node up" ничем не блокируется. Учтите также, что правила вы поменяли 16.07, а последний обрыв в логах — 15.07 22:18, то есть новые правила реальным обрывом ещё не проверялись.
Что проверить:
- нет ли выше (правила 1–30) правила с флагом "Stop event processing", под которое попадает SYS_NODE_UNREACHABLE от этих узлов;
- включите в конфиге сервера DebugTags=event.policy:6, воспроизведите обрыв и посмотрите в логе строки "match EPP rule" для события SYS_NODE_UNREACHABLE — будет видно, какие правила его обработали;
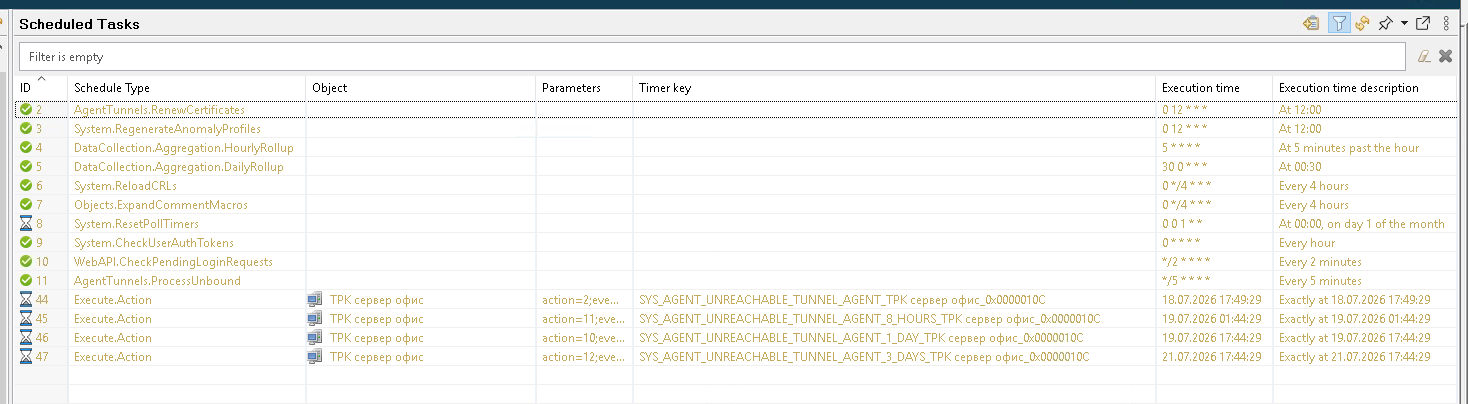
- после обрыва (пока не прошли 10 минут) откройте список Scheduled Tasks и проверьте, есть ли отложенная задача Execute.Action с ключом вида SYS_AGENT_UNREACHABLE_TUNNEL_AGENT_<имя узла>_<0x...>.
После следующего обрыва пришлите лог событий и список аварий по зависимому узлу.
- Отдельная и более серьёзная проблема — шторм аварий.
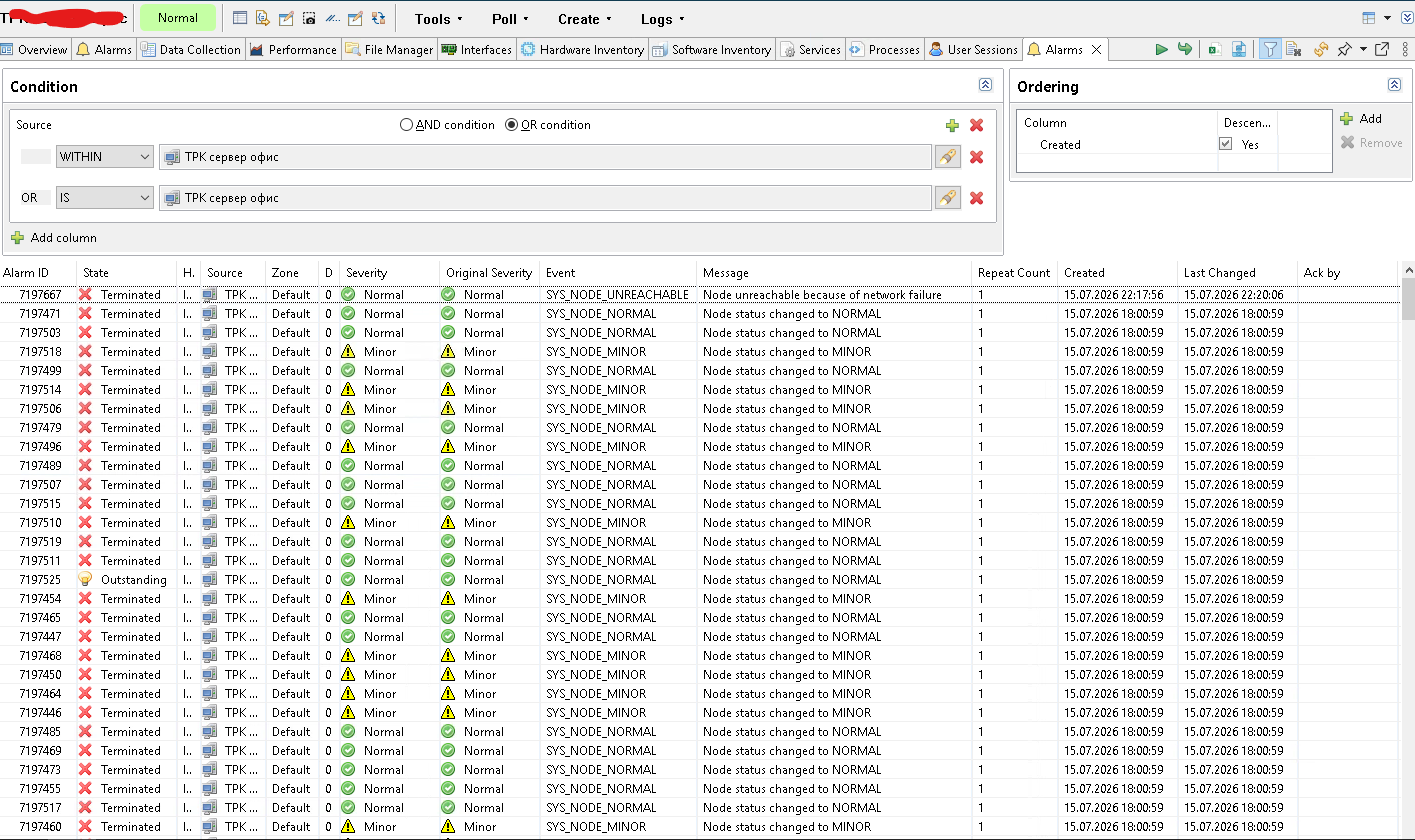
08.07 ID аварий были в районе 43, 15.07 — уже 7 197 667. Семь миллионов аварий за неделю. В логах видно почему: статус узла скачет NORMAL
 MINOR десятки раз в секунду (события SYS_NODE_MINOR / SYS_NODE_NORMAL с тегом NodeStatus), и на каждое такое событие создаётся авария. Это и есть причина постоянного роста базы и ошибок в alarm log. Покажите правило, которое создаёт аварии на события изменения статуса узла — скорее всего, его нужно убрать или сильно ограничить. И надо разбираться, почему статус так флапает — это лучше вынести в отдельную тему.
-
- Понял. Учту.
- Пока проверяю, отпишу. Вот характерный пример уведомлений. Выключил службу агента на прокси ноде ТРК сервер офис. Подождал 5 мин и включил службу агента на прокси ноде ТРК сервер офис. Итог уведомлений:
 18.Jul.2026 16:52:10
Severity Critical
ТРК сервер офис
 Node unreachable because of network failure
18.Jul.2026 16:58:28
Severity Normal 🟢
ТРК сервер KMS
Node up 18.Jul.2026 16:58:38
Severity Normal 🟢
ТРК сервер офис
Node upТ.е. сначала приходит уведомление от ноды за прокси ТРК сервер KMS (хотя уведомления быть не должно так как там таймер 600 сек) а потом уже от прокси ноды ТРК сервер офис.
- Понял. Создам отельную тему.
-
Итоги проверки:
- нет ли выше (правила 1–30) правила с флагом "Stop event processing", под которое попадает SYS_NODE_UNREACHABLE от этих узлов;
Не нашел такого.
Но нашел другие правила (NEW Telegram alarm when Интернет резерв is stop responding ICMP и NEW Telegram alarm when Интернет резерв is start responding ICMP). Я создавал его когда пытался отключить уведомления от подчиненных нод за прокси при пропадании интернета.
Убрал из секции cancel the following timers таймеры по этим нодам. Может они влияли еще. Теперь эти правила выглядят так (новые правила NEW Telegram alarm when Интернет резерв).
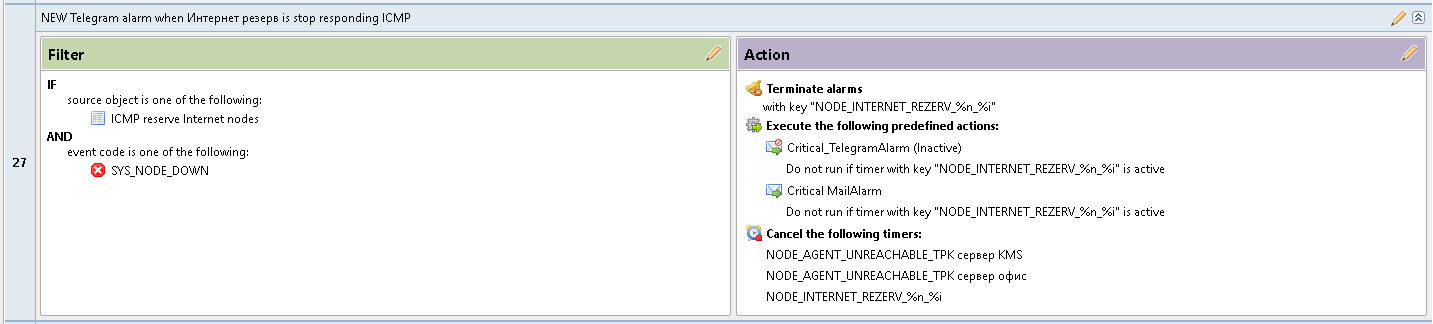
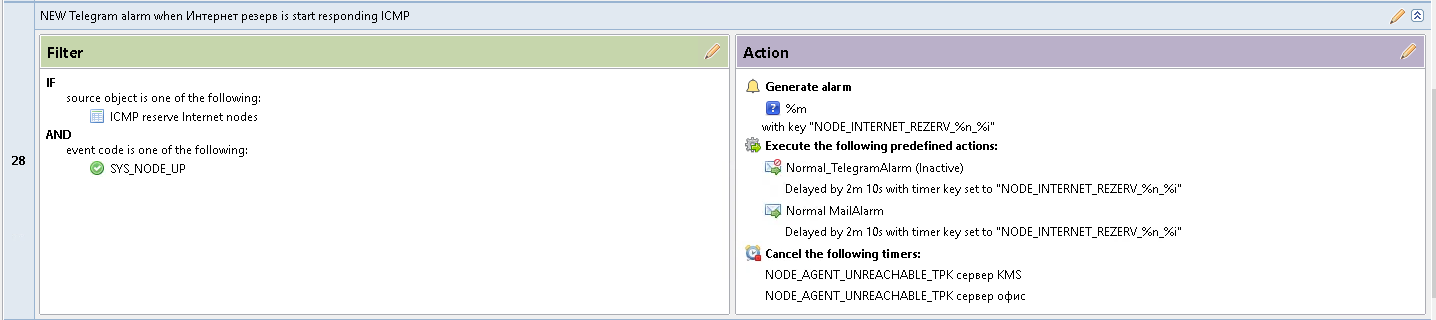
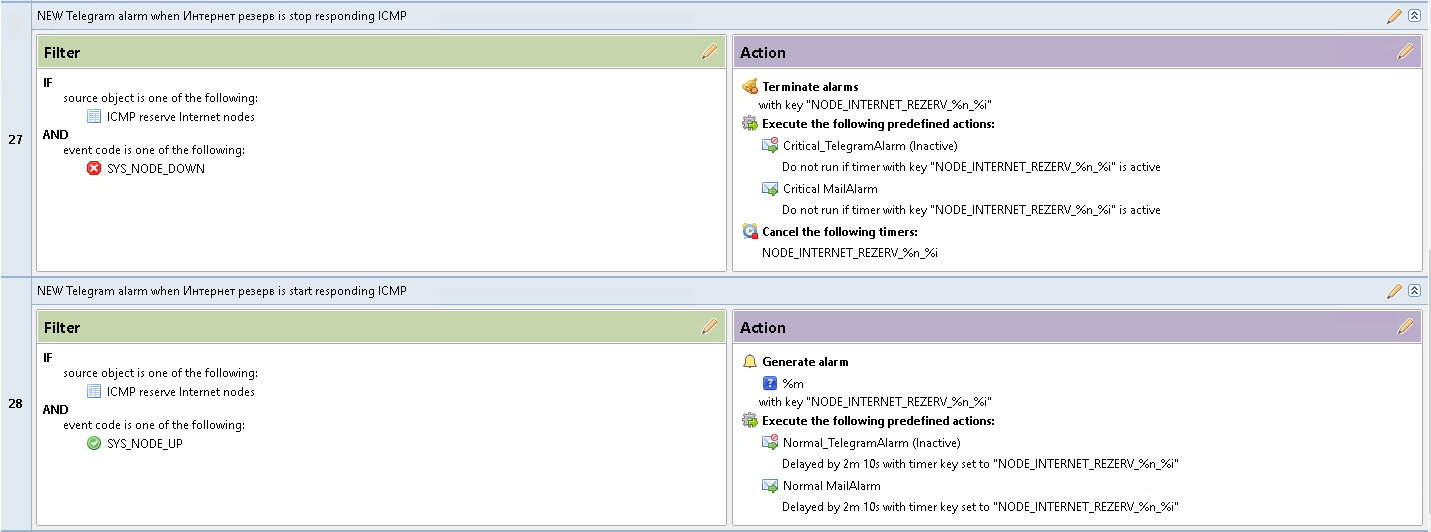
-
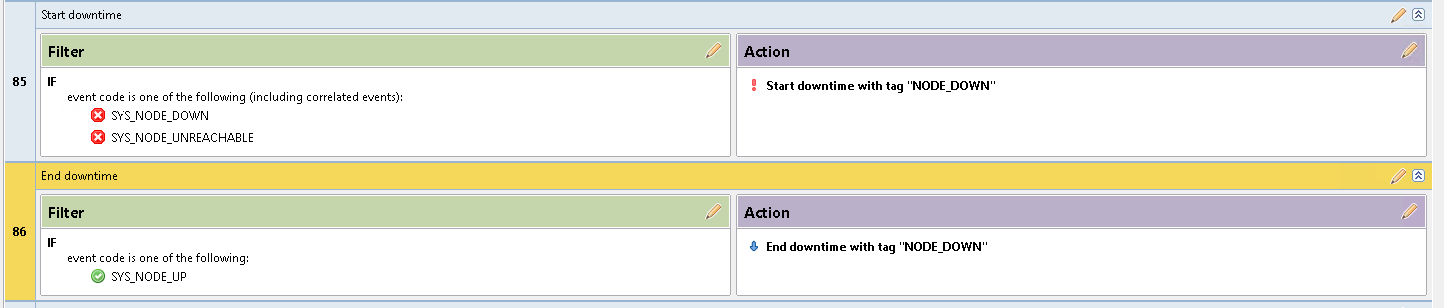
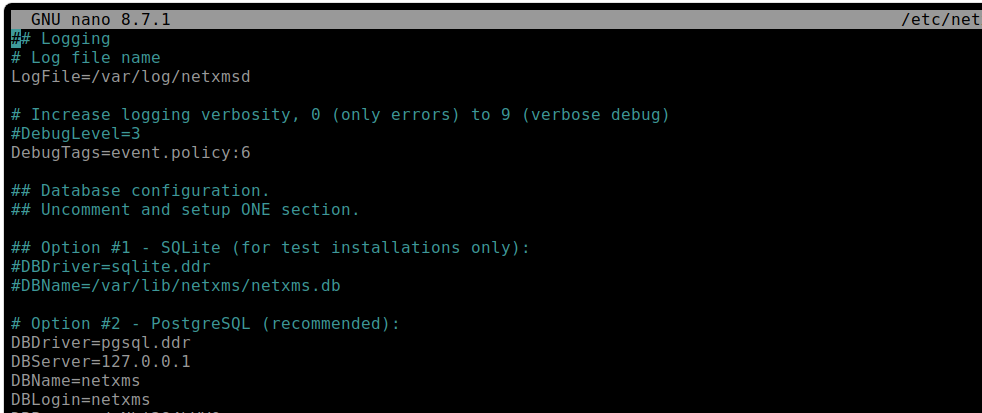
- включите в конфиге сервера DebugTags=event.policy:6, воспроизведите обрыв и посмотрите в логе строки "match EPP rule" для события SYS_NODE_UNREACHABLE — будет видно, какие правила его обработали;
Отредактировал файл netxmsd.conf как на скриншоте, перезапустил сервер.
Но этогои посмотрите в логе строки "match EPP rule" для события SYS_NODE_UNREACHABLE — будет видно, какие правила его обработали
не нашел.
Искал на ноде с помощью Log - Events.Или имелось в виду лог сервера в файле в Ubuntu?
В логе сервера netxmsd нашел такие строки:
2026.07.18 17:30:14.313 *D* [event.policy ] Action 8 execution blocked by timer "SYS_AGENT_UNREACHABLE_TUNNEL_AGENT_ТРК сервер офис_0x0000010C" key
2026.07.18 17:30:14.313 *D* [event.policy ] Action 15 will not be executed, because id disabled
2026.07.18 17:30:14.313 *D* [event.policy ] Action 16 will not be executed, because id disabled
2026.07.18 17:30:14.313 *D* [event.policy ] Action 17 will not be executed, because id disabled
2026.07.18 17:30:14.321 *D* [event.policy ] Delayed action execution with key "SYS_AGENT_UNREACHABLE_TUNNEL_AGENT_1_DAY_ТРК сервер офис_0x0000010C" cancelled
2026.07.18 17:30:14.325 *D* [event.policy ] Delayed action execution with key "SYS_AGENT_UNREACHABLE_TUNNEL_AGENT_3_DAYS_ТРК сервер офис_0x0000010C" cancelled
2026.07.18 17:30:14.328 *D* [event.policy ] Delayed action execution with key "SYS_AGENT_UNREACHABLE_TUNNEL_AGENT_8_HOURS_ТРК сервер офис_0x0000010C" cancelled
2026.07.18 17:30:14.332 *D* [event.policy ] Delayed action execution with key "SYS_AGENT_UNREACHABLE_TUNNEL_AGENT_ТРК сервер офис_0x0000010C" cancelled
2026.07.18 17:30:14.332 *D* [event.policy ] Event 10517520 match EPP rule 86
2026.07.18 17:30:14.332 *D* [event.policy ] Requesting downtime "NODE_DOWN" end for object ТРК сервер офис [268]
2026.07.18 17:30:15.815 *D* [event.policy ] Event 10517519 match EPP rule 58
2026.07.18 17:30:25.251 *D* [event.policy ] Event 10517529 match EPP rule 2
2026.07.18 17:30:25.251 *D* [event.policy ] Event 10517529 match EPP rule 862026.07.18 17:31:15.102 *D* [event.policy ] Requesting downtime "NODE_DOWN" end for object ТРК сервер KMS [403]
2026.07.18 17:31:17.854 *D* [event.policy ] Event 10517615 match EPP rule 58
2026.07.18 17:31:19.144 *D* [event.policy ] Event 10517618 match EPP rule 2
2026.07.18 17:31:19.144 *D* [event.policy ] Event 10517618 match EPP rule 86

-
-
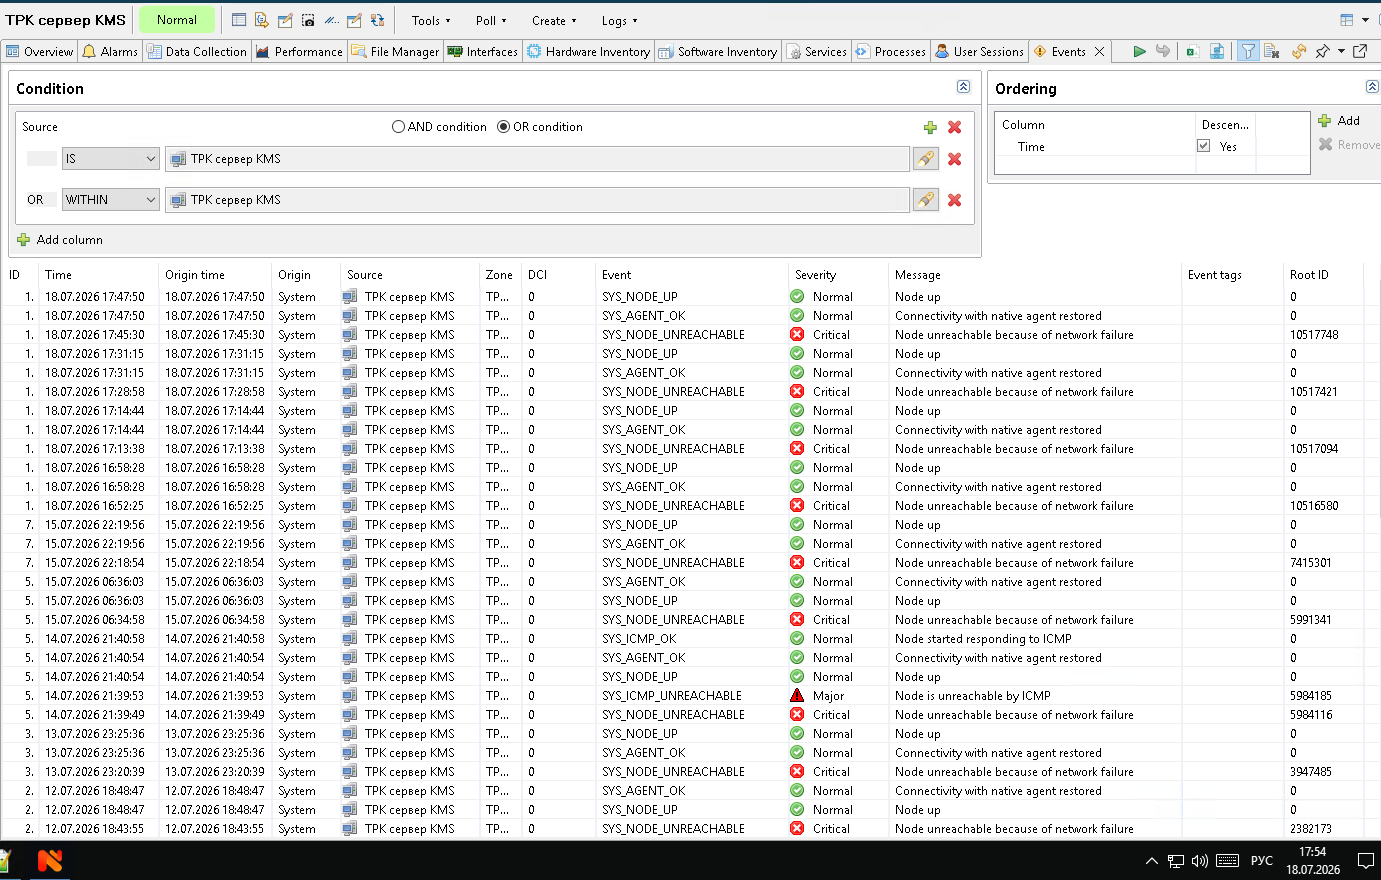
Прикладываю лог событий и лог аварий по узлам ТРК сервер офис (прокси нода) и ТРК сервер KMS (подчиненная нода за прокси). Тестировал так: на сервере ТРК сервер офис останавливал службу NetXMS Agent на 1,5-2 мин и включал снова.
Как итог: приходит уведомление только от подчиненной ноды ТРК сервер KMS
18.Jul.2026 17:47:50
Severity Normal 🟢
ТРК сервер KMS
Node up
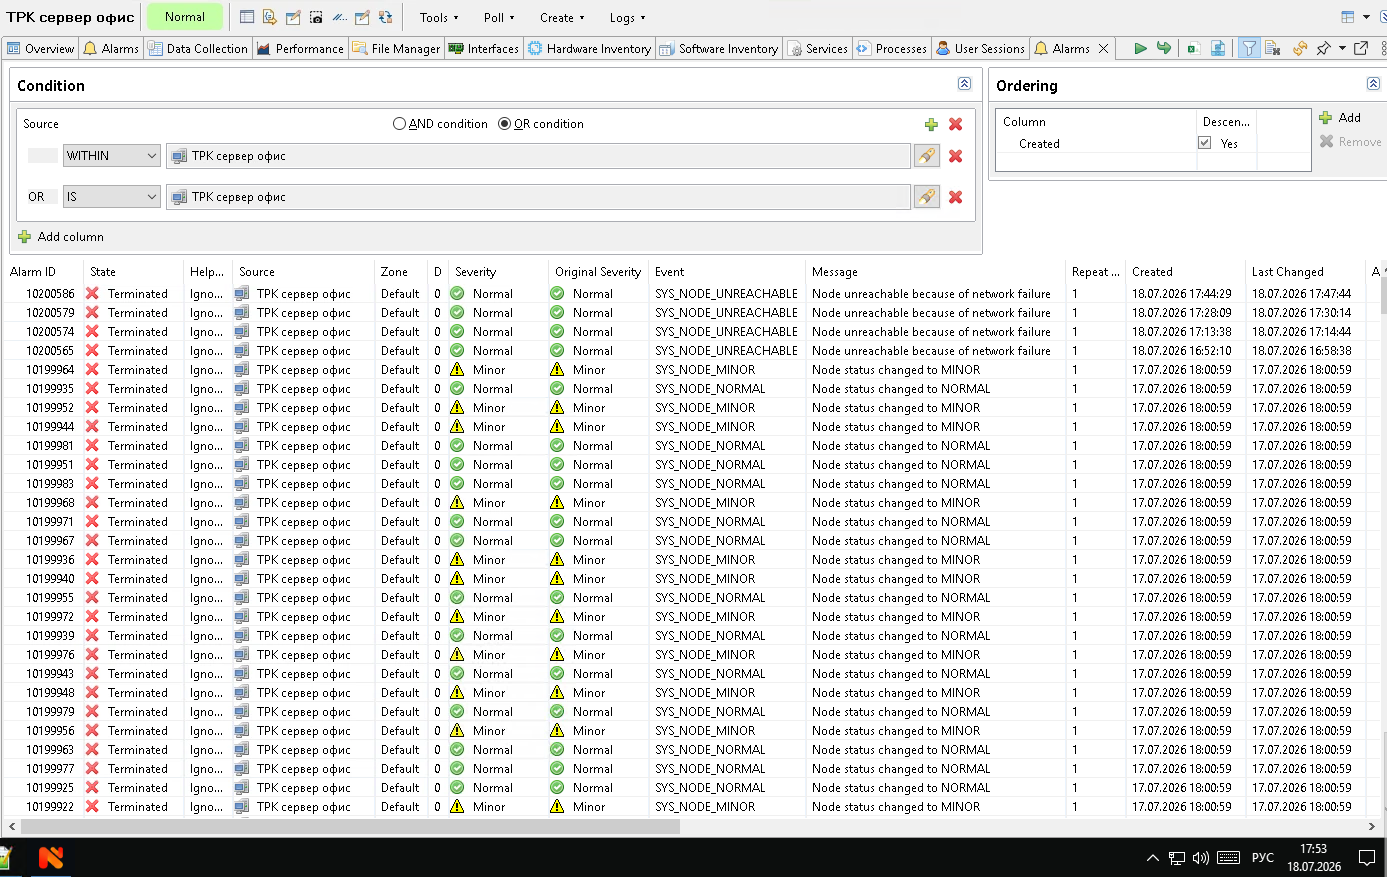
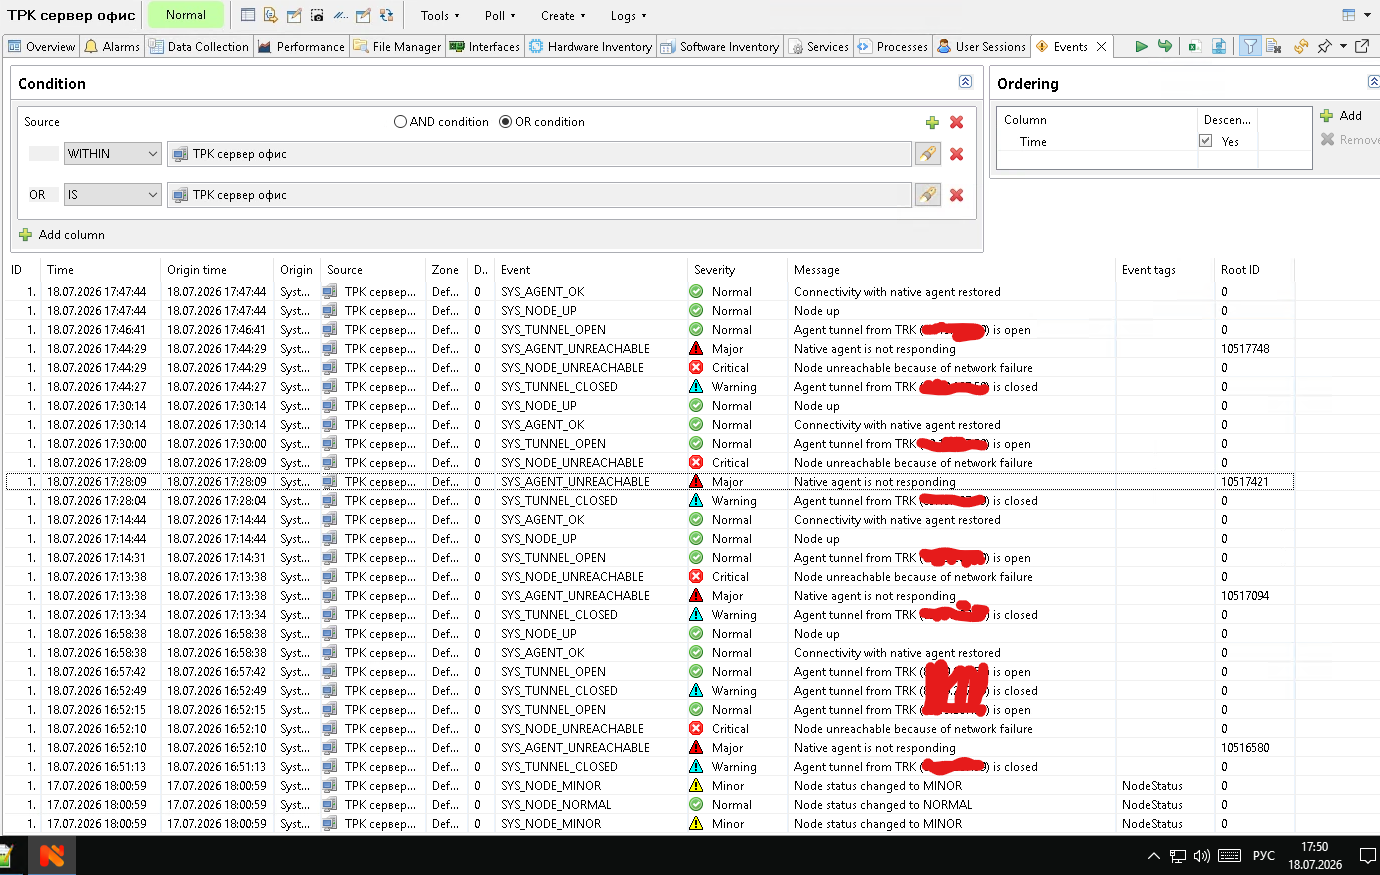
-
Проблема в коррелированных событиях. Когда узел за прокси становится недоступен, сервер связывает его SYS_NODE_UNREACHABLE с корневым событием прокси. Правила EPP по умолчанию пропускают коррелированные события — правило обрабатывает их только если в его свойствах включена опция "Accept correlated events". У стандартных правил (например, 85 "Start downtime") она включена — поэтому в фильтре видно "including correlated events". У ваших правил 31/33/34 её нет.
Отсюда всё поведение из вашего лога: событие недоступности "ТРК сервер KMS" не совпало ни с одним из ваших правил (только со стандартными 2/58/86), поэтому не создались ни аварии, ни блокирующие таймеры. А SYS_NODE_UP при восстановлении не коррелируется никогда — правило 34 срабатывает и сразу шлёт "Node up", блокировать его нечем. У прокси всё работает, потому что его собственное событие недоступности не коррелированное.
Что сделать: откройте свойства правила 33 и включите "Accept correlated events". После этого при коротком обрыве прокси таймер будет создаваться и уведомление "Node up" от подчинённых узлов будет блокироваться — так же, как сейчас у прокси.
Один нюанс: при длительном обрыве прокси подчинённые узлы теперь тоже пришлют отложенные уведомления о недоступности (Critical MailAlarm через 10 минут и далее). Если они не нужны — учтите, что просто выключить эти действия нельзя: неактивное действие не создаёт таймер, и блокировка перестанет работать. В этом случае вместо уведомления назначьте отложенным действием с тем же ключом таймера какое-нибудь пустое действие.
Изменённые правила 27/28 по "Интернет резерв" теперь на основную схему не влияют.
-
-
Коррелированное событие — это событие, для которого сервер уже определил причину и привязал его к корневому событию. Так происходит в нескольких случаях: недоступность узла за прокси/маршрутизатором/коммутатором привязывается к событию падения этого прокси или коммутатора; interface down, SNMP fail, service down на узле, который сам недоступен, привязываются к его же SYS_NODE_DOWN; все события от объекта в режиме обслуживания привязываются к событию входа в maintenance.
По умолчанию правила EPP такие события пропускают, и это осознанное поведение: уведомлять нужно о причине, а не о каждом следствии. Упал коммутатор — приходит одно уведомление о коммутаторе, а не сотня о каждом узле за ним.
Поэтому всегда включать этот флаг не нужно. Включайте его только в правилах, которые должны отработать на каждом событии независимо от того, есть ли у него известная причина: учёт простоя (стандартные правила Start/End downtime), создание аварий и блокирующих таймеров по каждому узлу — ваш случай с правилом 33. В обычных уведомляющих правилах флаг лучше оставить выключенным, иначе вернётся шквал уведомлений о следствиях.
Один нюанс: события от узлов в режиме обслуживания тоже считаются коррелированными, поэтому правило с включённым флагом будет срабатывать и во время maintenance. Если это нежелательно, добавьте в фильтрующий скрипт правила проверку [tt]return !$object->isInMaintenanceMode;[/tt] (это атрибут, без скобок).
-
Понял.
Один нюанс: события от узлов в режиме обслуживания тоже считаются коррелированными, поэтому правило с включённым флагом будет срабатывать и во время maintenance. Если это нежелательно, добавьте в фильтрующий скрипт правила проверку [tt]return !$object->isInMaintenanceMode;[/tt] (это атрибут, без скобок).
Опробую это. Отпишу
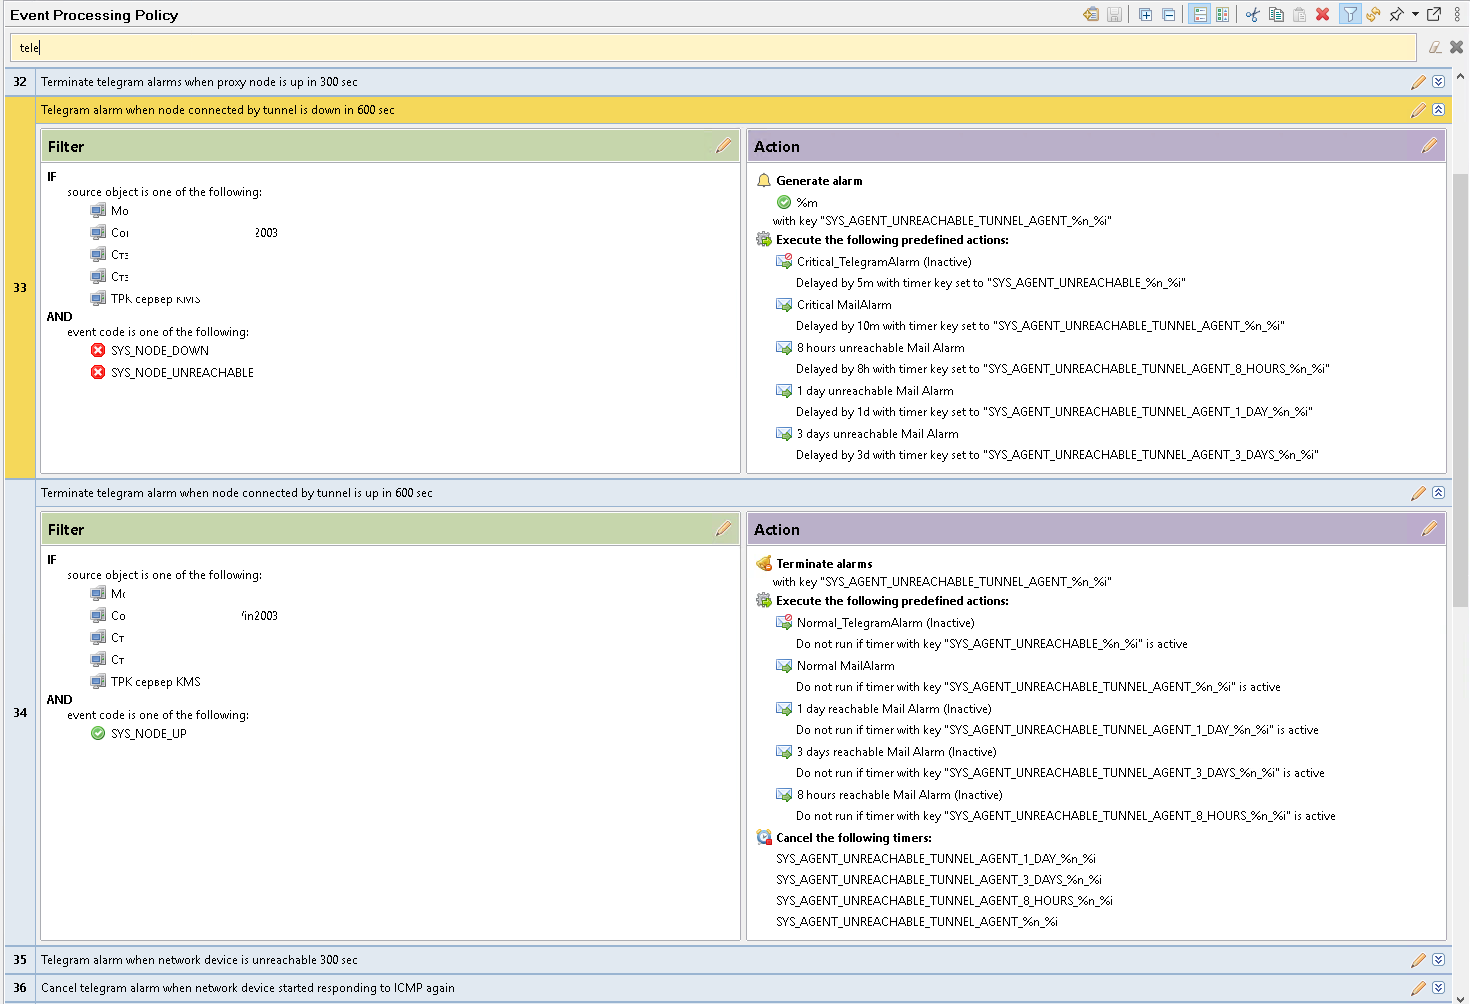
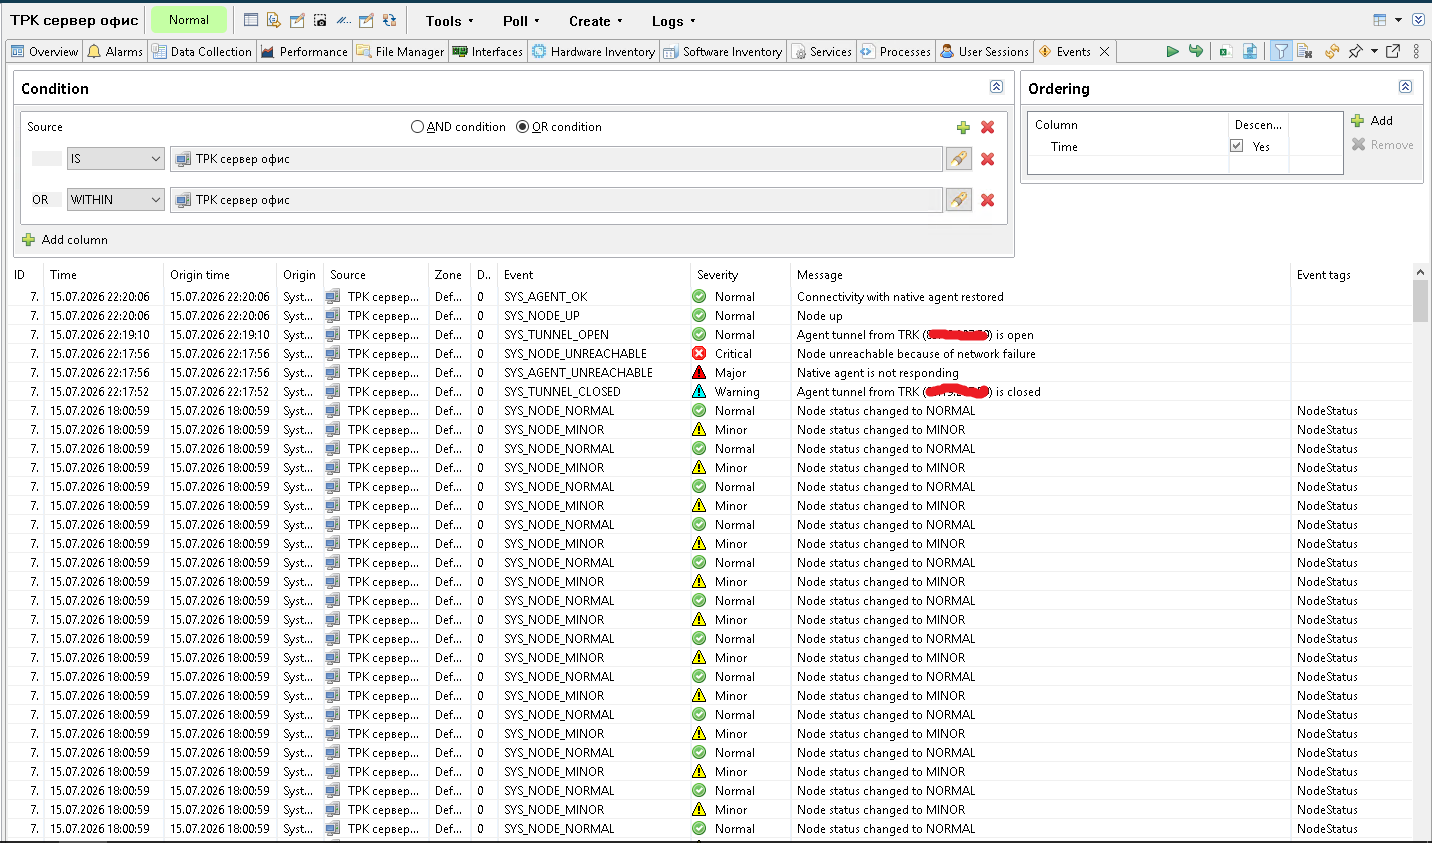
Hello! It looks like you're interested in this conversation, but you don't have an account yet.
Getting fed up of having to scroll through the same posts each visit? When you register for an account, you'll always come back to exactly where you were before, and choose to be notified of new replies (either via email, or push notification). You'll also be able to save bookmarks and upvote posts to show your appreciation to other community members.
With your input, this post could be even better 💗
Register Login