
Шквал оповещений после кратковременной потери контакта с прокси нодой
-
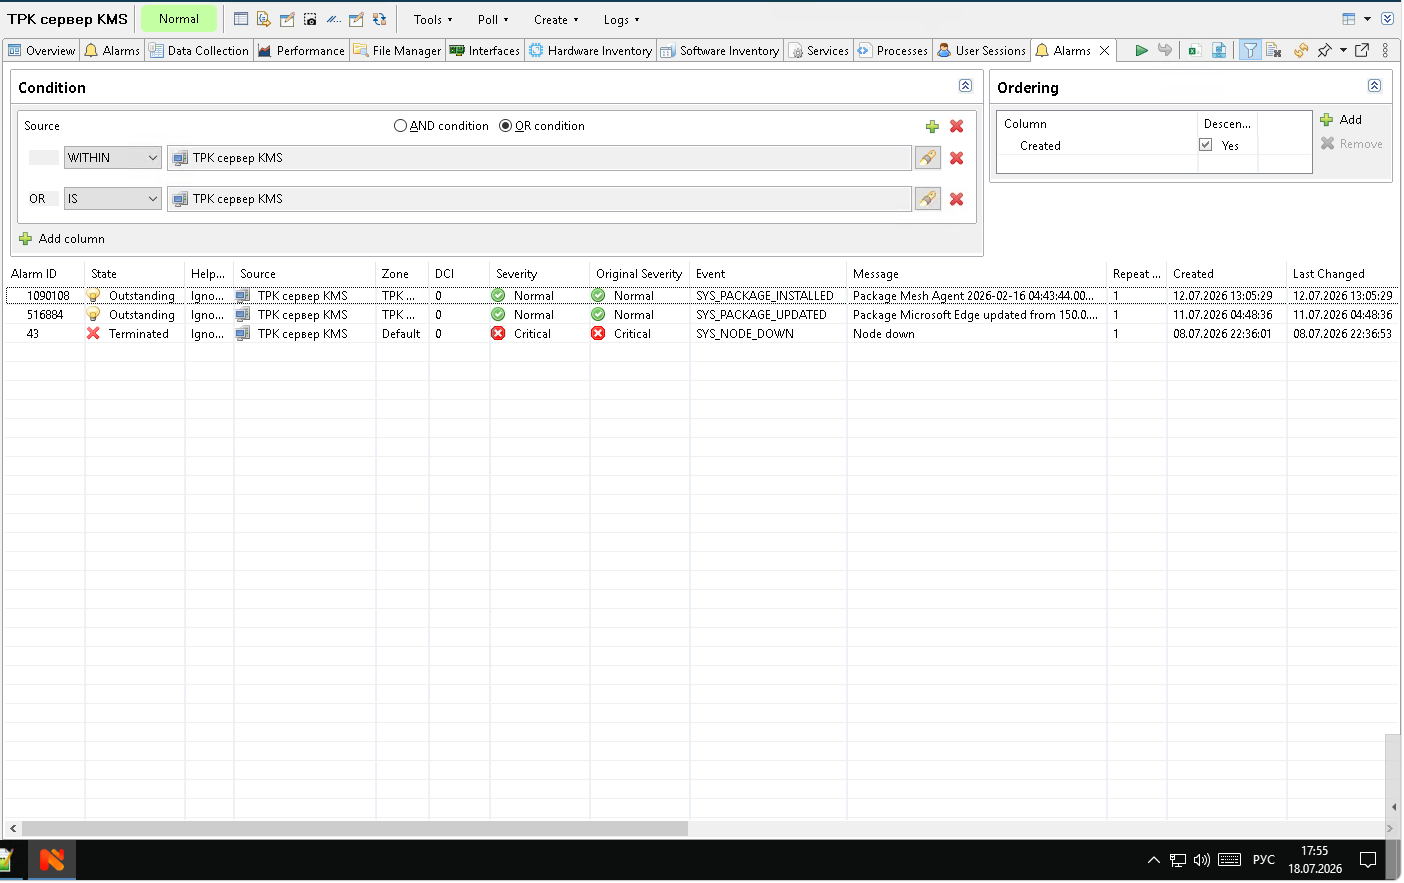
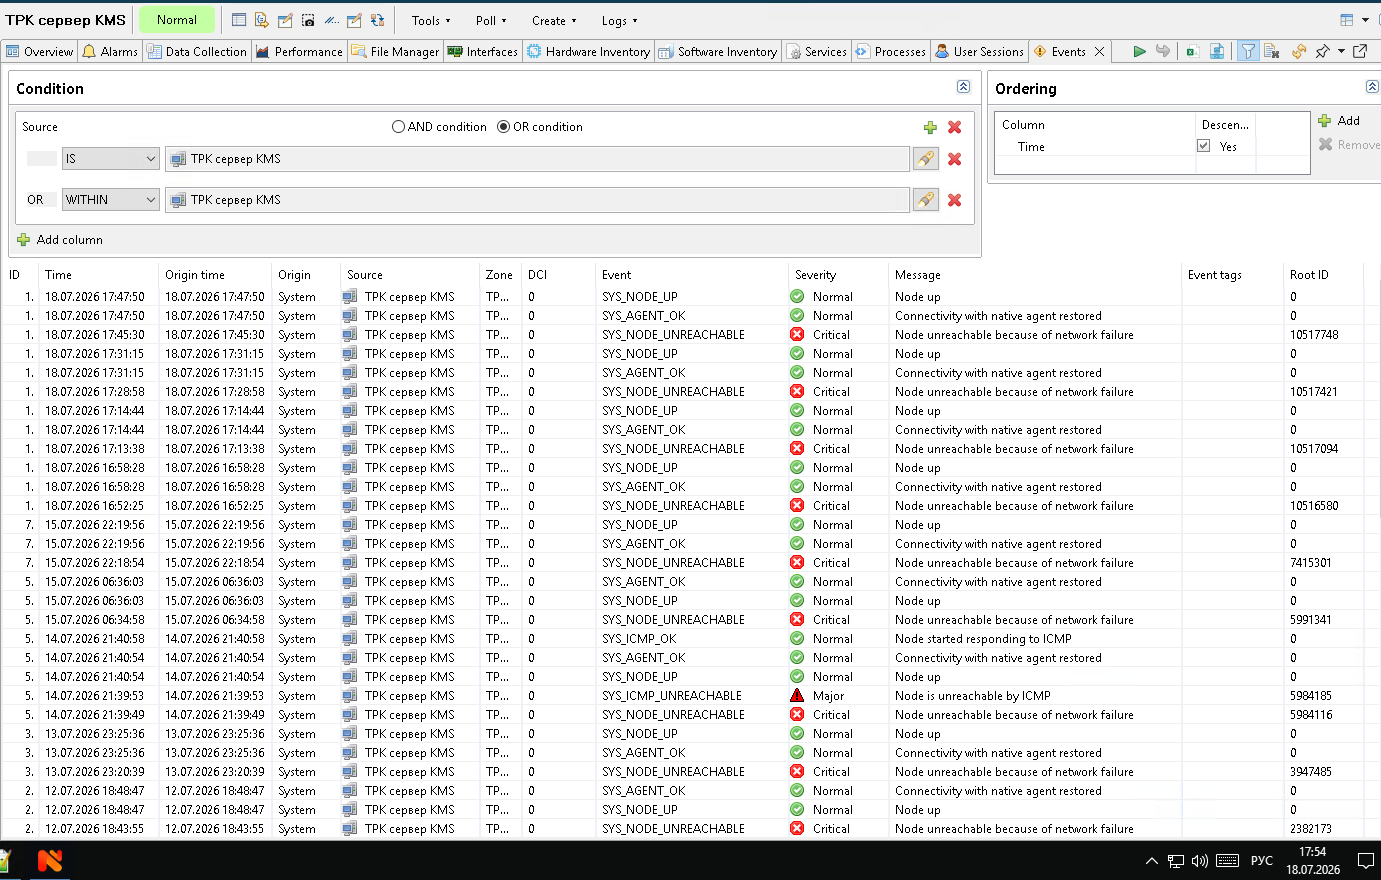
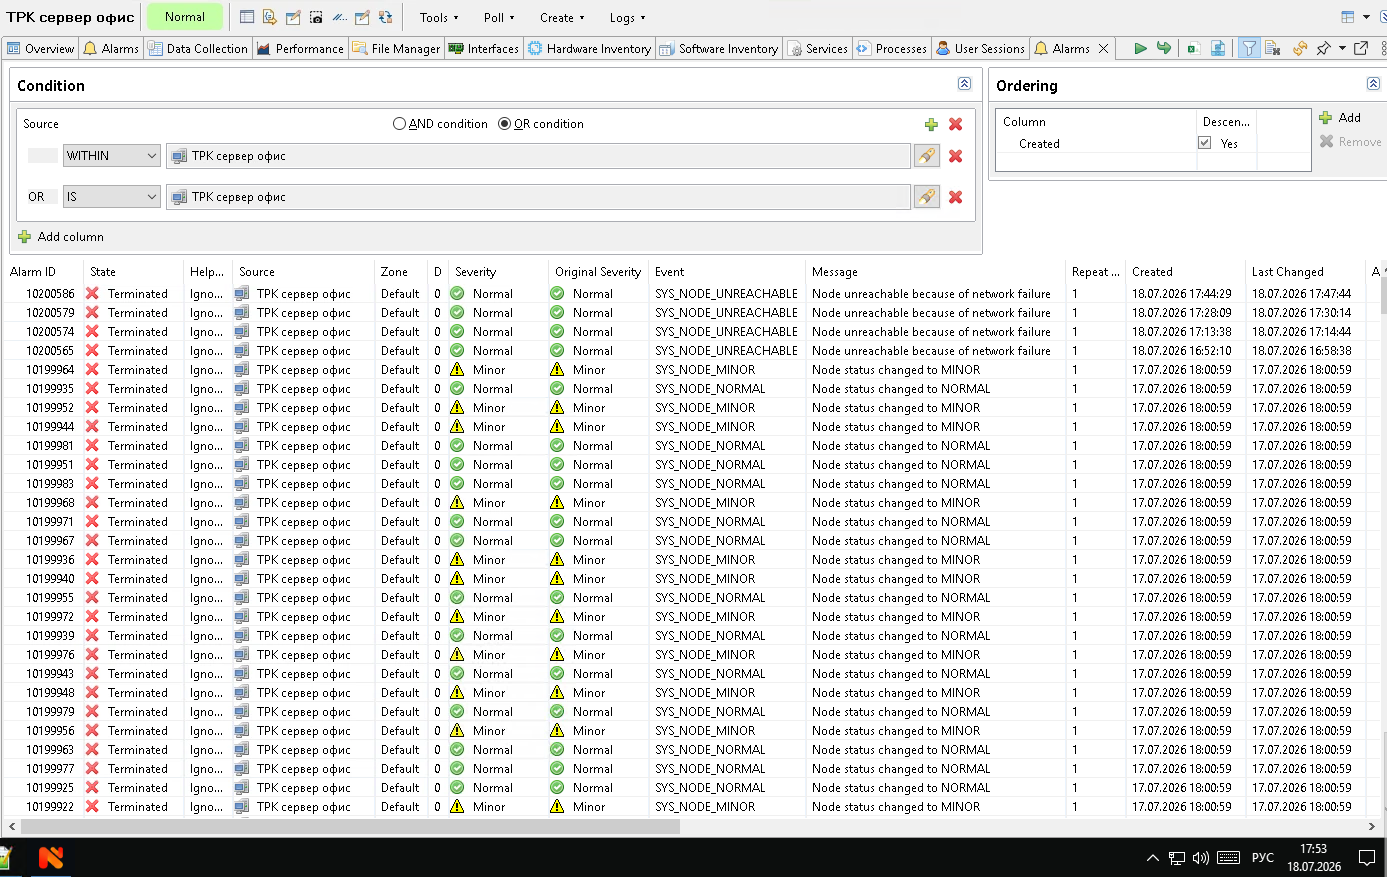
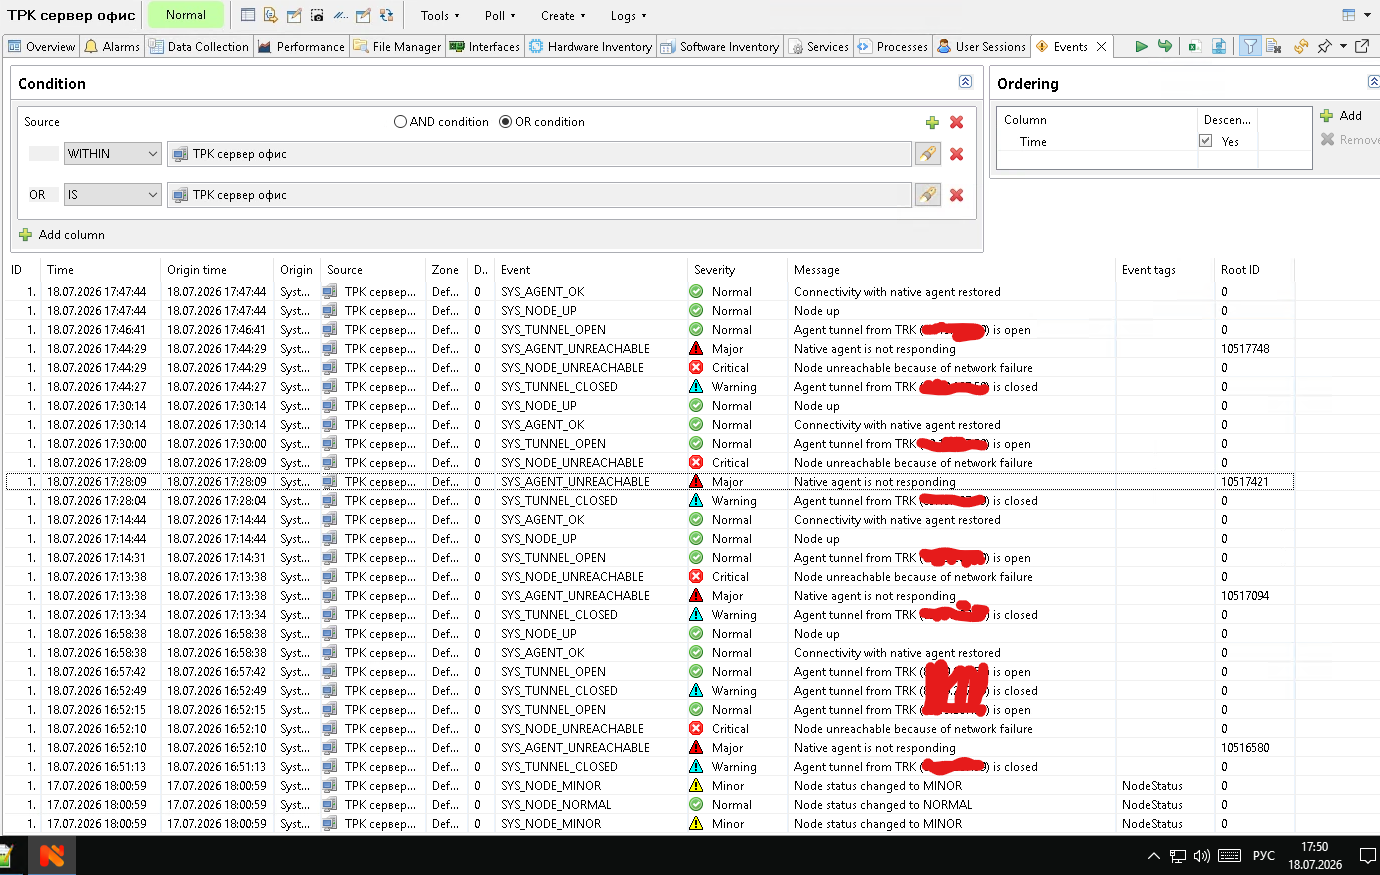
Прикладываю лог событий и лог аварий по узлам ТРК сервер офис (прокси нода) и ТРК сервер KMS (подчиненная нода за прокси). Тестировал так: на сервере ТРК сервер офис останавливал службу NetXMS Agent на 1,5-2 мин и включал снова.
Как итог: приходит уведомление только от подчиненной ноды ТРК сервер KMS
 18.Jul.2026 17:47:50
Severity Normal 🟢
ТРК сервер KMS
 Node up
-
Проблема в коррелированных событиях. Когда узел за прокси становится недоступен, сервер связывает его SYS_NODE_UNREACHABLE с корневым событием прокси. Правила EPP по умолчанию пропускают коррелированные события — правило обрабатывает их только если в его свойствах включена опция "Accept correlated events". У стандартных правил (например, 85 "Start downtime") она включена — поэтому в фильтре видно "including correlated events". У ваших правил 31/33/34 её нет.
Отсюда всё поведение из вашего лога: событие недоступности "ТРК сервер KMS" не совпало ни с одним из ваших правил (только со стандартными 2/58/86), поэтому не создались ни аварии, ни блокирующие таймеры. А SYS_NODE_UP при восстановлении не коррелируется никогда — правило 34 срабатывает и сразу шлёт "Node up", блокировать его нечем. У прокси всё работает, потому что его собственное событие недоступности не коррелированное.
Что сделать: откройте свойства правила 33 и включите "Accept correlated events". После этого при коротком обрыве прокси таймер будет создаваться и уведомление "Node up" от подчинённых узлов будет блокироваться — так же, как сейчас у прокси.
Один нюанс: при длительном обрыве прокси подчинённые узлы теперь тоже пришлют отложенные уведомления о недоступности (Critical MailAlarm через 10 минут и далее). Если они не нужны — учтите, что просто выключить эти действия нельзя: неактивное действие не создаёт таймер, и блокировка перестанет работать. В этом случае вместо уведомления назначьте отложенным действием с тем же ключом таймера какое-нибудь пустое действие.
Изменённые правила 27/28 по "Интернет резерв" теперь на основную схему не влияют.
-
-
Коррелированное событие — это событие, для которого сервер уже определил причину и привязал его к корневому событию. Так происходит в нескольких случаях: недоступность узла за прокси/маршрутизатором/коммутатором привязывается к событию падения этого прокси или коммутатора; interface down, SNMP fail, service down на узле, который сам недоступен, привязываются к его же SYS_NODE_DOWN; все события от объекта в режиме обслуживания привязываются к событию входа в maintenance.
По умолчанию правила EPP такие события пропускают, и это осознанное поведение: уведомлять нужно о причине, а не о каждом следствии. Упал коммутатор — приходит одно уведомление о коммутаторе, а не сотня о каждом узле за ним.
Поэтому всегда включать этот флаг не нужно. Включайте его только в правилах, которые должны отработать на каждом событии независимо от того, есть ли у него известная причина: учёт простоя (стандартные правила Start/End downtime), создание аварий и блокирующих таймеров по каждому узлу — ваш случай с правилом 33. В обычных уведомляющих правилах флаг лучше оставить выключенным, иначе вернётся шквал уведомлений о следствиях.
Один нюанс: события от узлов в режиме обслуживания тоже считаются коррелированными, поэтому правило с включённым флагом будет срабатывать и во время maintenance. Если это нежелательно, добавьте в фильтрующий скрипт правила проверку [tt]return !$object->isInMaintenanceMode;[/tt] (это атрибут, без скобок).
-
Понял.
Один нюанс: события от узлов в режиме обслуживания тоже считаются коррелированными, поэтому правило с включённым флагом будет срабатывать и во время maintenance. Если это нежелательно, добавьте в фильтрующий скрипт правила проверку [tt]return !$object->isInMaintenanceMode;[/tt] (это атрибут, без скобок).
Опробую это. Отпишу
-
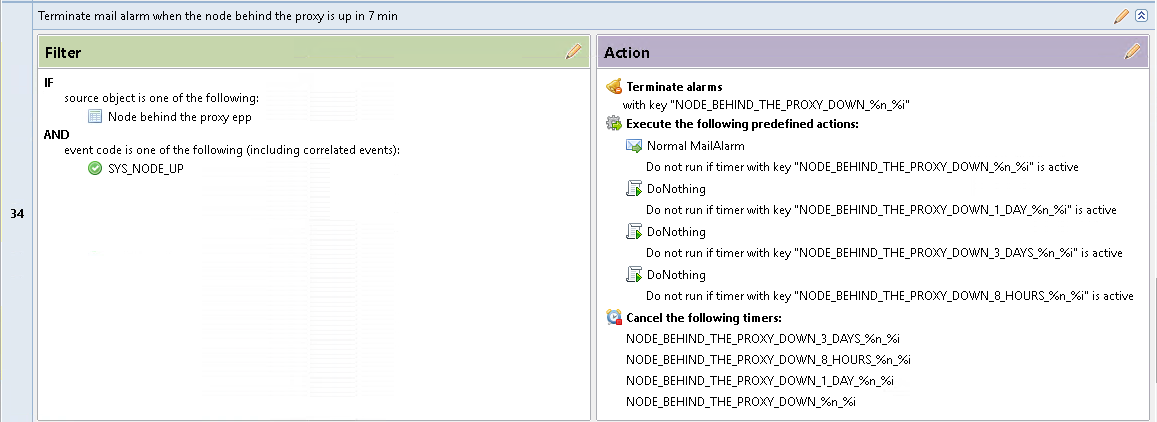
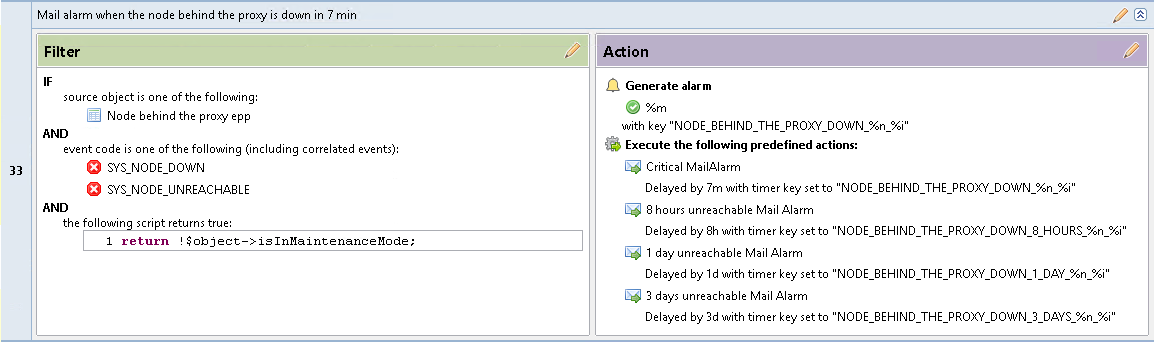
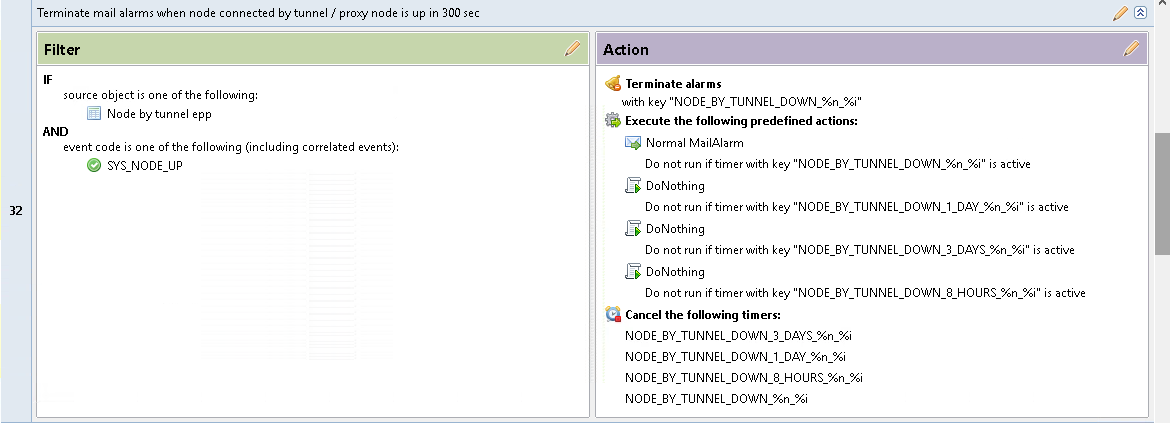
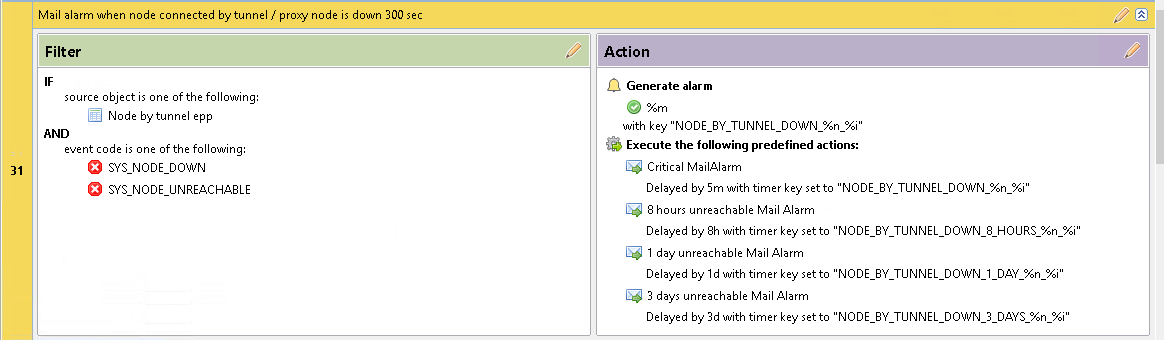
С учетом полученной информации получились такие правила.
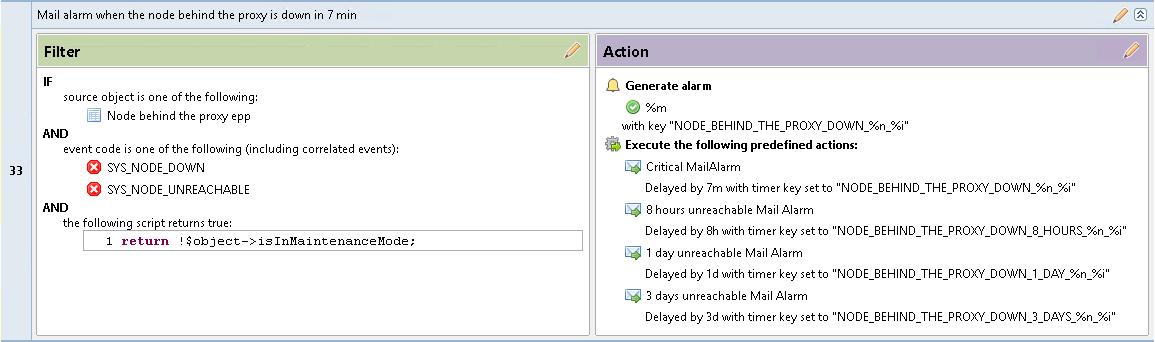
Опцию "Accept correlated events" включал только на правиле 33 Mail alarm when the node behind the proxy is down in 600 sec (или Уведомление по почте при отключении ноды за прокси-сервером в течение 600 секунд).
Пока еще проверяю во всех режимах
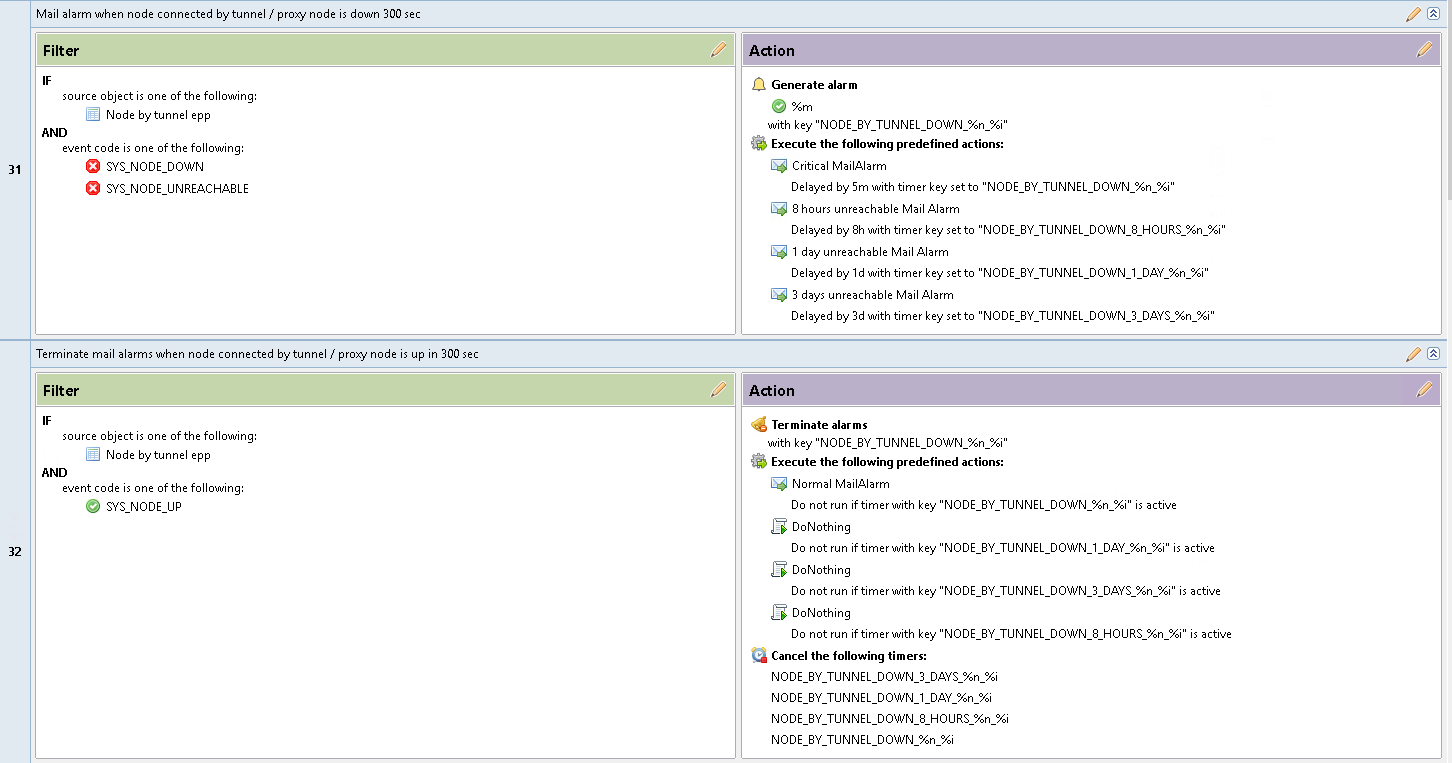
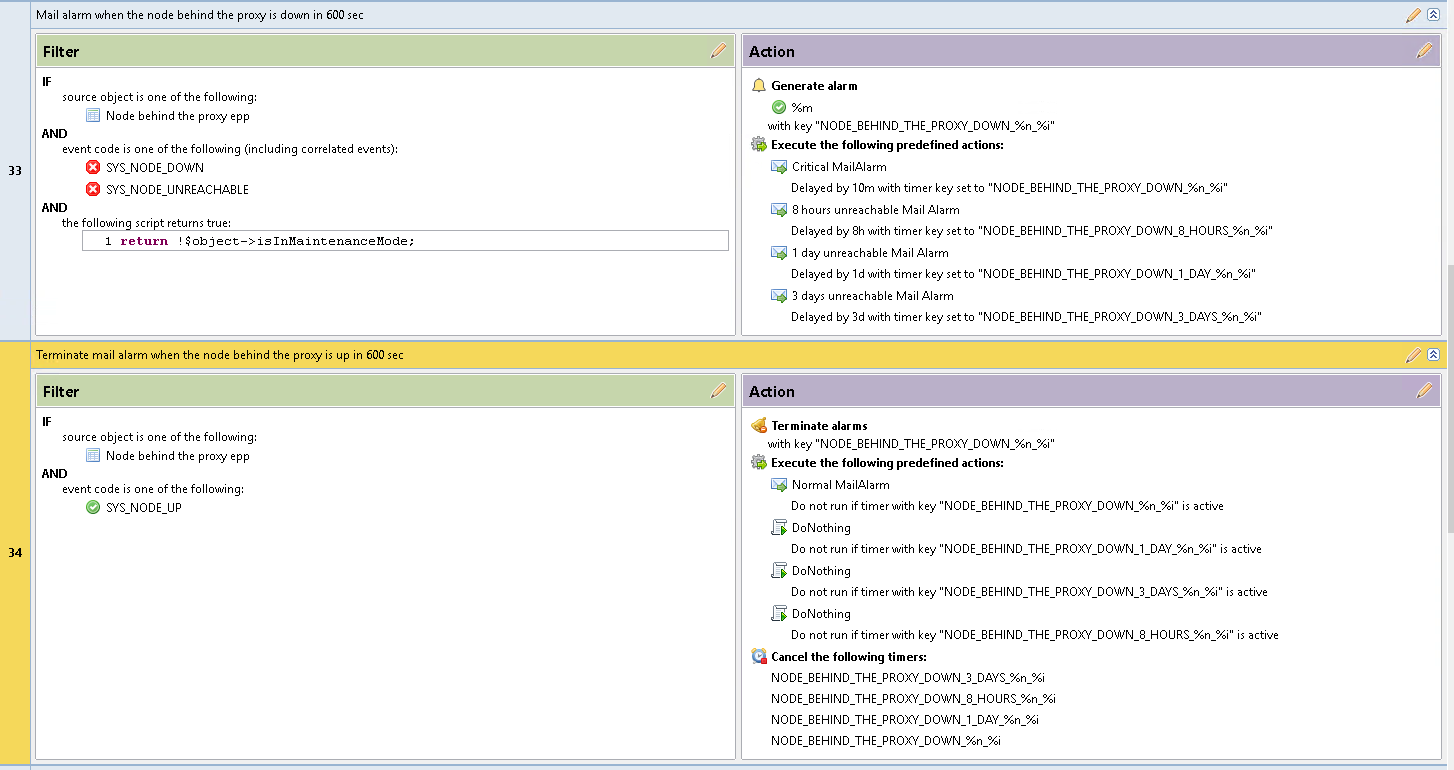
-
-
Можно обойтись одной парой. Ключи таймеров и алармов у вас содержат %n_%i, то есть уникальны для каждой ноды — при объединении правил конфликта не будет.
Флаг "Accept correlated events" не переключает правило в другой режим, он только дополнительно разрешает коррелированные события. Некоррелированные обрабатываются в любом случае. Собственное SYS_NODE_DOWN прокси-ноды некоррелированное, SYS_NODE_UNREACHABLE ноды за прокси — коррелированное, поэтому одно правило с включённым флагом покрывает оба случая.
Чтобы слить 31/33 в одно правило: в фильтре указать обе группы (Node by tunnel epp и Node behind the proxy epp) или вообще убрать фильтр по объектам, включить "Accept correlated events", оставить скрипт с проверкой maintenance. То же самое с 32/34.
Две пары имеет смысл держать в двух случаях:
- нужны разные задержки — сейчас у вас 5 минут для прокси и 10 для подчинённых нод; в одном правиле останется одна;
- нужно ограничить действие флага узким списком нод. SYS_NODE_UNREACHABLE коррелируется не только при падении прокси, но и при падении маршрутизатора или коммутатора на пути. Правило с флагом, охватывающее все ноды, при падении коммутатора сработает на каждой ноде за ним — вместо одного письма о коммутаторе придёт письмо на каждую недоступную ноду. Пока в группах только ноды за прокси, этого не случится, но при расширении фильтра на всё дерево — случится.
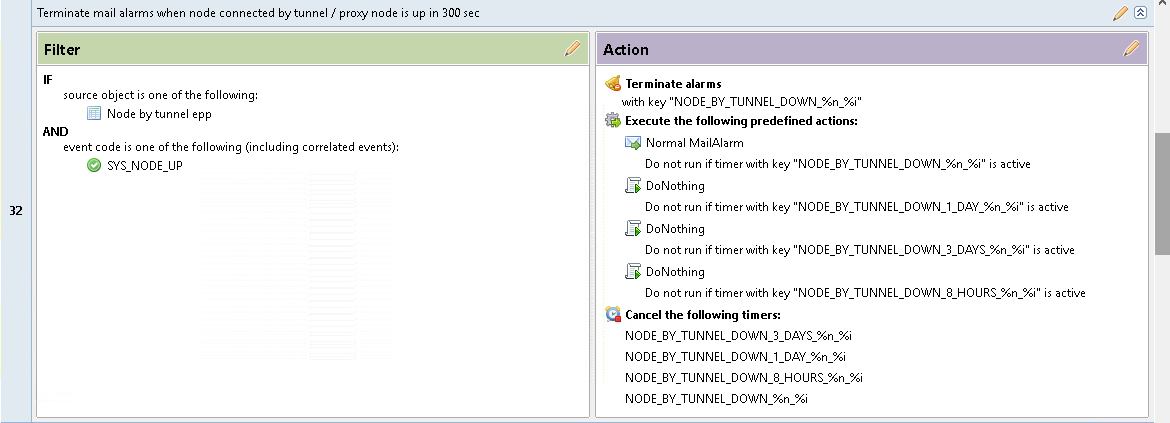
Отдельно про правила 32/34 (Node up). SYS_NODE_UP не коррелируется никогда, кроме одного случая: все события от объекта в maintenance mode считаются коррелированными. Отсюда сценарий: нода упала (таймеры созданы), после этого её перевели в обслуживание, она поднялась — правило Node up событие пропустит, аларм не закроется и отложенные действия не отменятся, и через 8 часов придёт письмо о недоступности уже работающей ноды. Так что на правилах Node up флаг "Accept correlated events" лучше тоже включить — во всех остальных ситуациях он там ни на что не влияет.
-
С учетом полученной информации оставлю 2 пары правил.
На все ноды правила распространять не буду так как не по всем нужны уведомления.
Я правильно понял что при таком раскладе на всех 4 правилах нужно включить опцию приема кореллированных событий и скрипт с проверкой maintenance? -
Не на всех — иначе сломается сценарий с maintenance, который чинили выше. По правилам:
- 33 (нода за прокси, down) — флаг ON + скрипт maintenance
- 31 (прокси, down) — ни флага, ни скрипта
- 32 / 34 (up) — флаг ON, скрипт не добавлять
Почему по-разному:
Down. У ноды за прокси событие SYS_NODE_UNREACHABLE коррелированное — без флага правило 33 не сработает вообще. Раз флаг включён, правило начнёт срабатывать и во время обслуживания, поэтому там нужен return !$object->isInMaintenanceMode;. У прокси собственное SYS_NODE_DOWN некоррелированное, обрабатывается и без флага; а в режиме обслуживания его события становятся коррелированными, и правило само их пропустит — ни скрипт, ни флаг там не нужны.
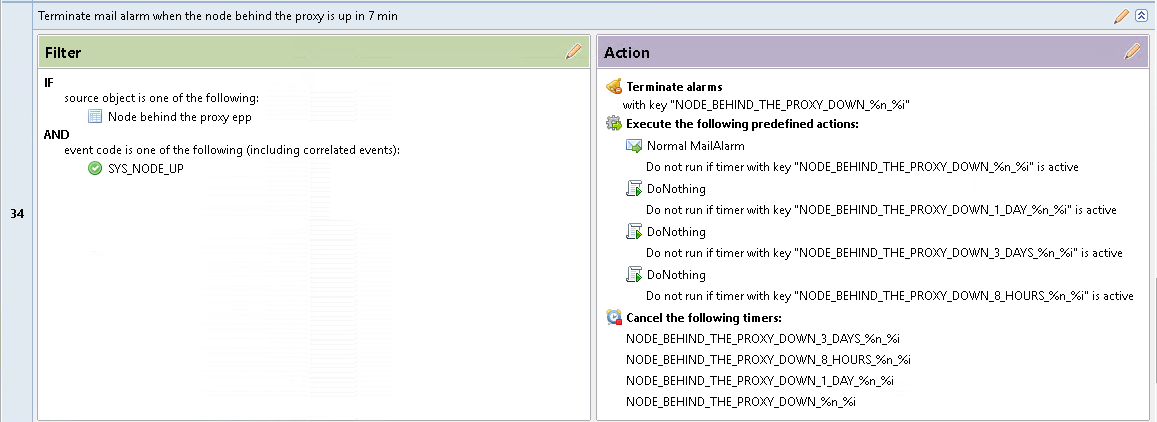
Up. SYS_NODE_UP коррелируется только когда нода в maintenance — и это ровно тот случай, ради которого флаг включается: нода поднялась в обслуживании, правило должно пропустить событие, закрыть аларм и снять отложенные действия. Если добавить туда проверку maintenance, правило пропустит это событие мимо, аларм не закроется, и через 8 часов придёт письмо о работающей ноде — вернётся исходный баг.
-
-
-
Да, всё верно — по всем четырём флаг и скрипт стоят правильно:
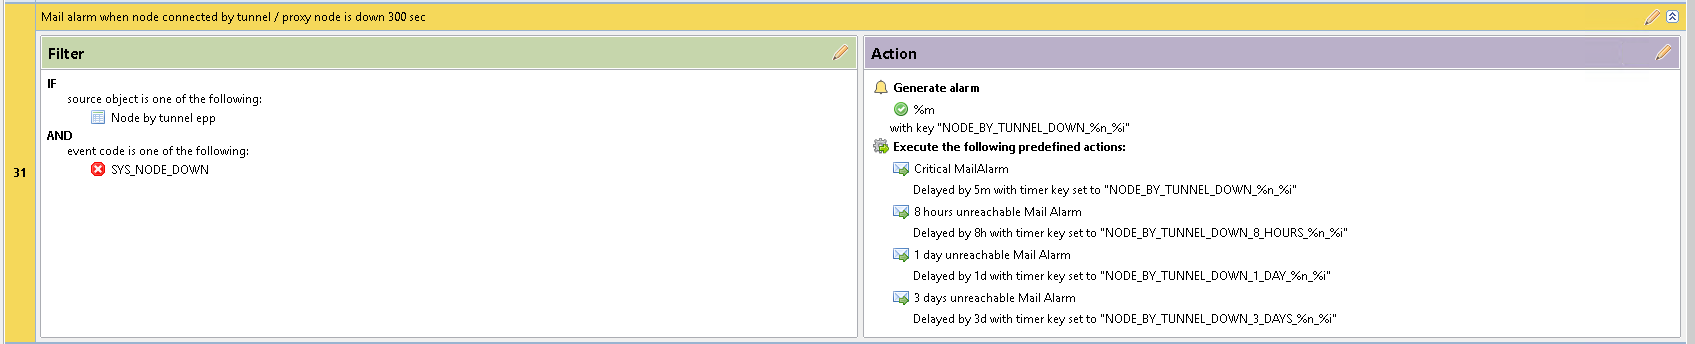
- 31 (прокси down) — флаг выключен, скрипта нет
- 32 (прокси up) — флаг включён, скрипта нет
- 33 (нода за прокси down) — флаг включён + скрипт maintenance
- 34 (нода за прокси up) — флаг включён, скрипта нет
Ключи таймеров и алармов между парами согласованы (NODE_BY_TUNNEL_DOWN_* в 31/32, NODE_BEHIND_THE_PROXY_DOWN_* в 33/34), а Terminate alarms и Cancel timers в up-правилах перекрывают все ключи из down-правил. Работать будет как задумано.
Одна мелочь, ни на что не влияет: в фильтре правила 31 рядом с SYS_NODE_DOWN стоит SYS_NODE_UNREACHABLE. Для ноды, подключённой напрямую по тоннелю, недоступность — это SYS_NODE_DOWN; SYS_NODE_UNREACHABLE у неё не возникает, а если бы возникло — оно коррелированное и при выключенном флаге всё равно было бы пропущено. Можно оставить как есть.
-
-
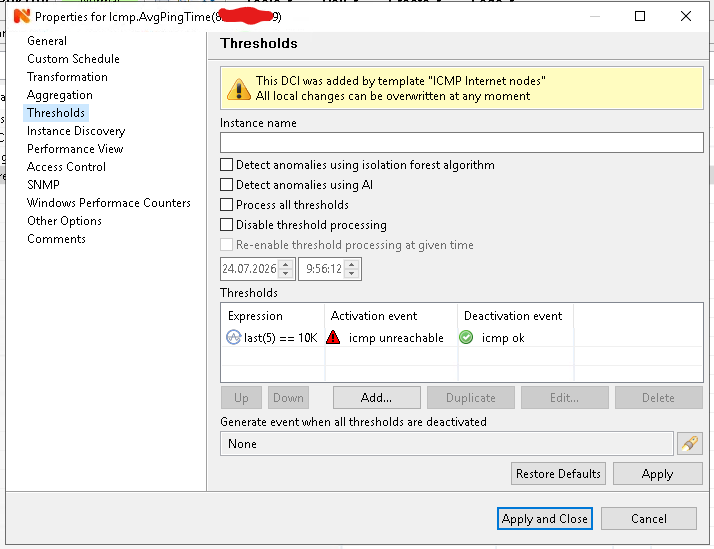
Если применить этот подход к другим правилам самописным. Имеется 2 правила цель которых уведомлять что пинг на wan ip адрес роутера филиала стал недоступен.
Правило Правило 25 Mail alarm when Internet is not responding in 90 sec (Уведомление по почте что интернет недоступен через 90 сек)
Правило 26 Mail alarm when Internet is start responding ICMP (Уведомление по почте что интернет стал доступен).
Wan ip адреса роутеров пингую через субагент ping с сервера netxms и шаблоном распространяю на нужные ноды.Вопрос: с учетом полученной информации выше я включил прием кореллированных событий только на правиле 26 Mail alarm when Internet is start responding ICMP. Это верный подход?
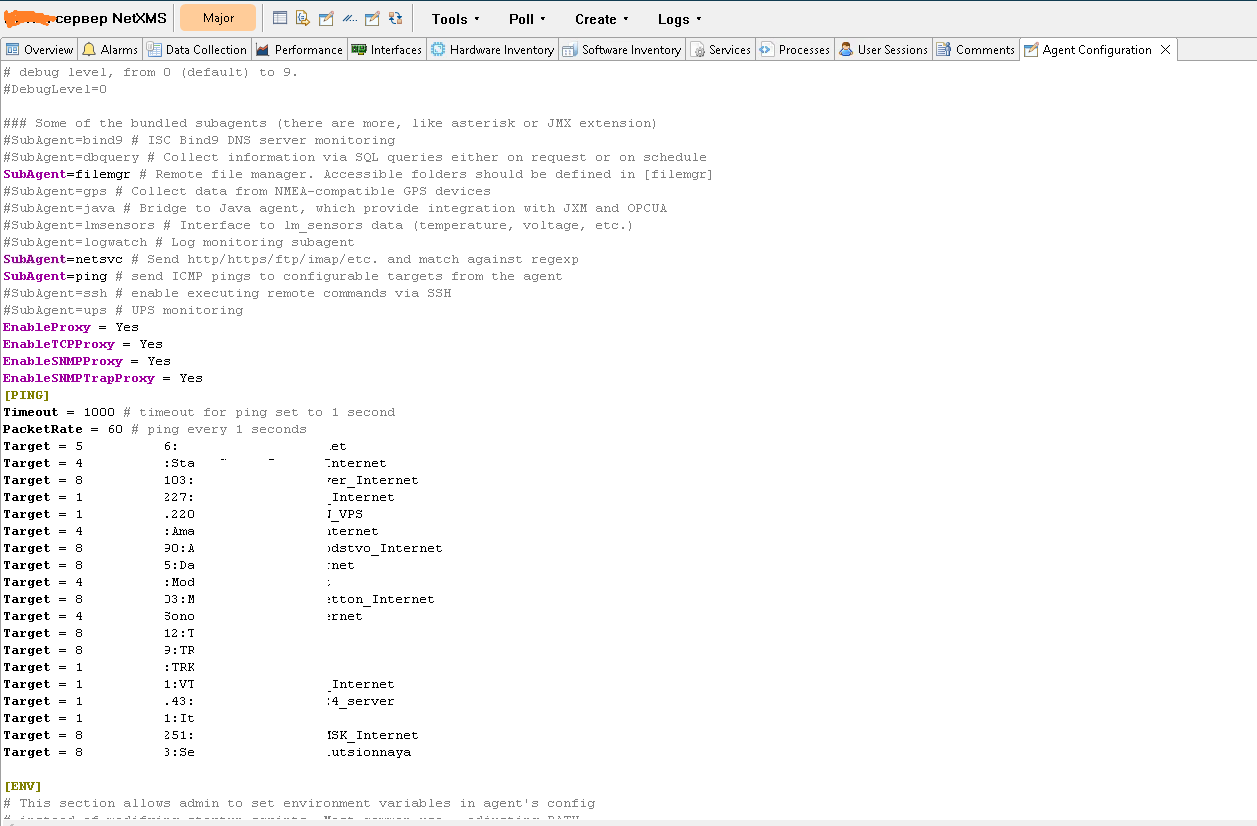
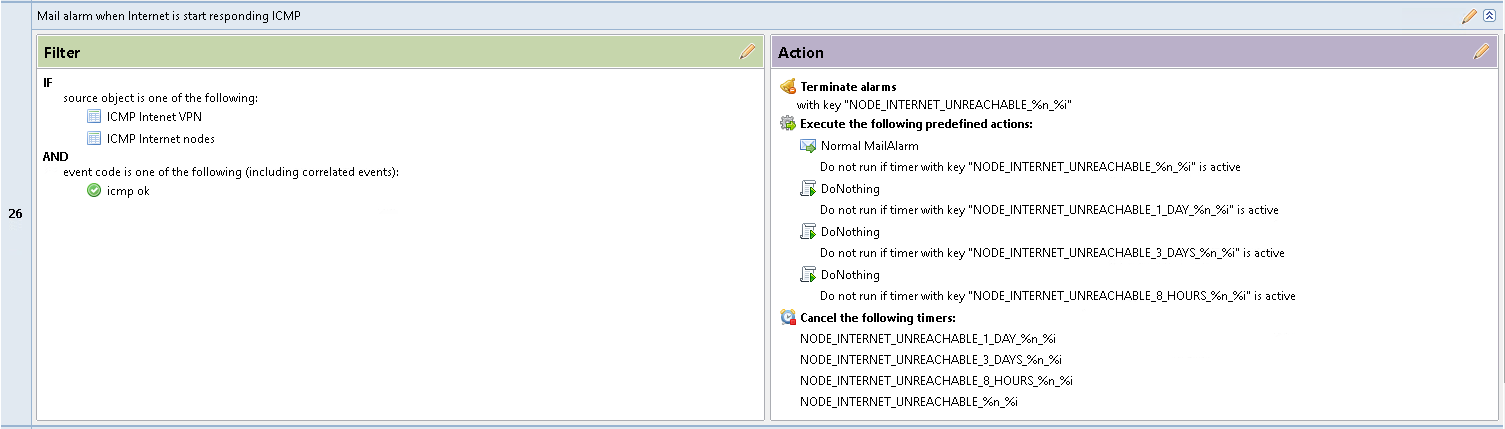

-
Да, подход верный. Ваши icmp unreachable / icmp ok — кастомные события, а для кастомных событий корреляция существует ровно в одном случае: когда нода-источник в режиме обслуживания (там коррелируются вообще все её события). К падению ноды, прокси или коммутатора сервер их никогда не привязывает — это делается только для фиксированного списка системных событий (SYS_ICMP_UNREACHABLE, SYS_INTERFACE_DOWN и т.д.).
Поэтому пара 25/26 — тот же случай, что 31/32, и логика распределяется так же:
- Правило 25 без флага: в нормальной работе события некоррелированные, правило срабатывает всегда. В maintenance они становятся коррелированными, и правило само их пропустит — скрипт с проверкой не нужен.
- Правило 26 с флагом: нужен ровно для сценария «интернет упал (аларм создан, таймеры 8h/1d/3d заведены) → ноду перевели в обслуживание → интернет восстановился». Без флага icmp ok будет пропущено, аларм останется висеть, и через 8 часов придёт письмо о недоступности уже работающего интернета.
Одно замечание на будущее: системное SYS_ICMP_UNREACHABLE при падении ноды коррелируется к её SYS_NODE_DOWN, а ваш кастомный icmp unreachable — нет. Если нода, на которой висит этот DCI, упадёт целиком, придут оба уведомления — и о ноде, и об интернете. Для порогов с кастомными событиями корреляция такие следствия не гасит.
-
Одно замечание на будущее: системное SYS_ICMP_UNREACHABLE при падении ноды коррелируется к её SYS_NODE_DOWN, а ваш кастомный icmp unreachable — нет. Если нода, на которой висит этот DCI, упадёт целиком, придут оба уведомления — и о ноде, и об интернете. Для порогов с кастомными событиями корреляция такие следствия не гасит.
--------------
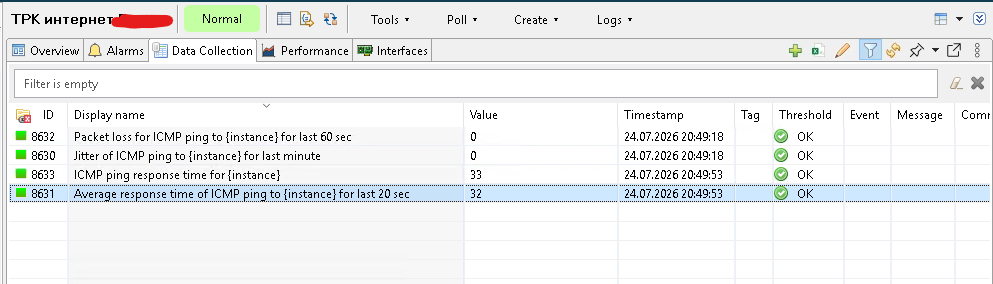
Это правило висит на ноде "Интернет название филиала". Завел отдельную ноду которую так обозвал. И так с каждым внешним ip адресом филиала.
Прокси нода и другие сервера выделены в отдельные ноды. Цель: получение отдельных уведомлений о недоступности интернета в филиалах и серверов в этих филиалах. Есть филиалы с основным и резервным интернетом, есть те у кого проблемы с электропитанием.
-
Что-то не так работает как ожидалось.
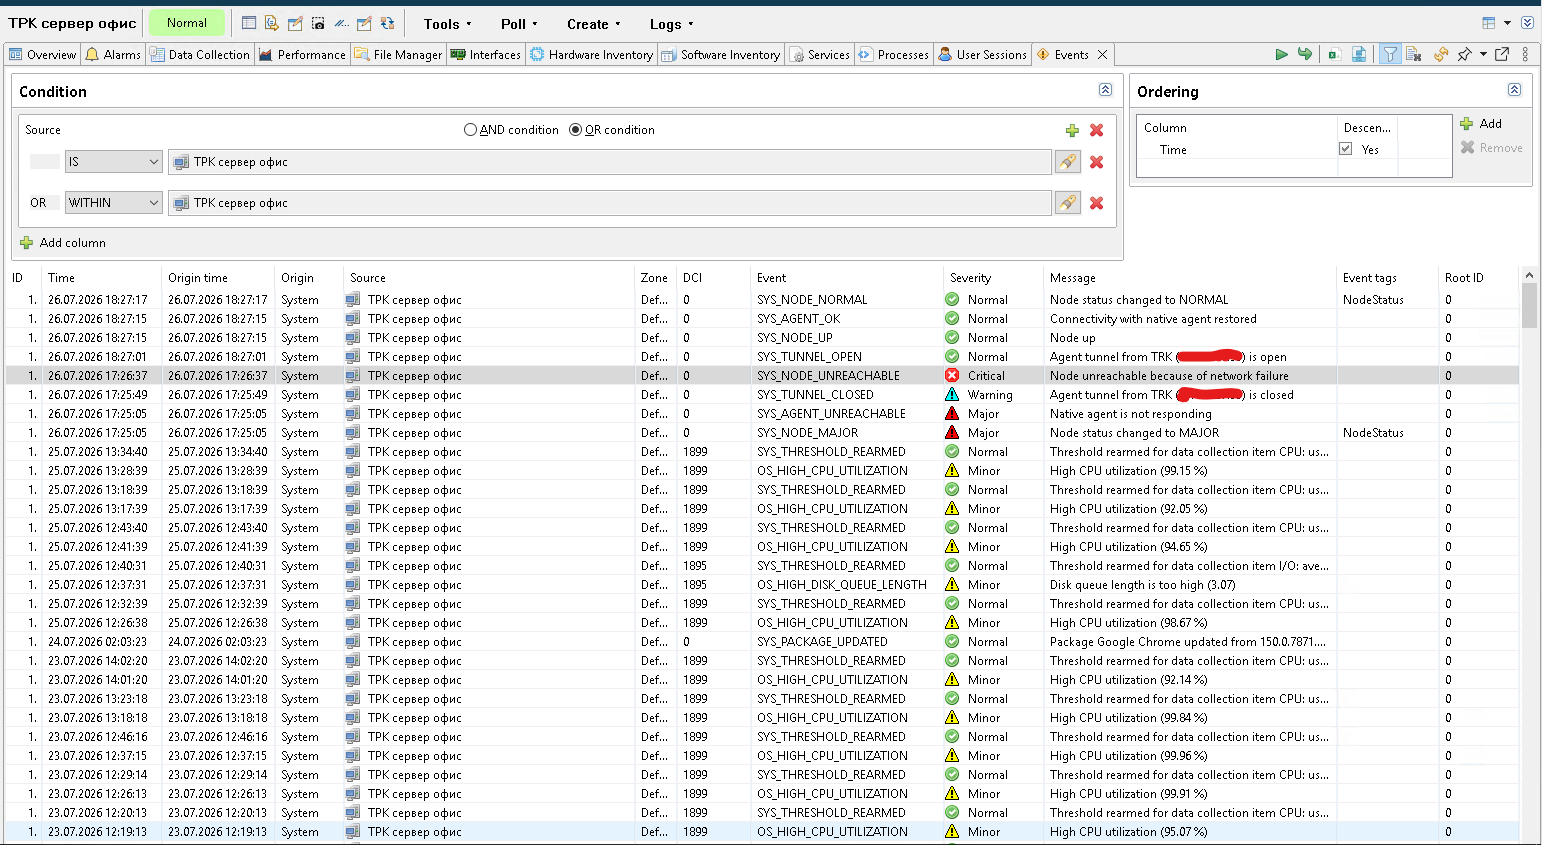
Было отключение интернета в филиале с 17.26 до 18.26 26.07.2026.
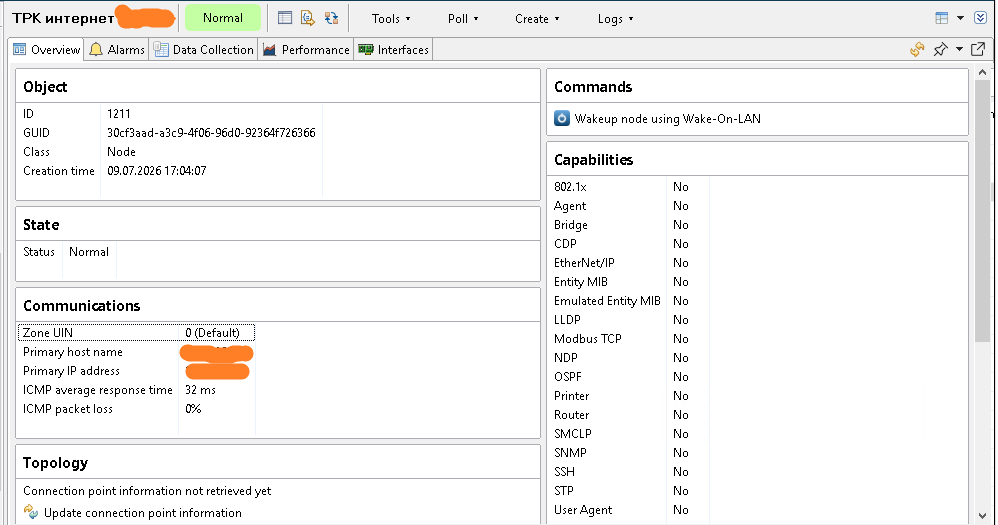
Пришло уведомление об отключении интернета и уведомление о недоступности ноды ТРК KMS (это нода за прокси). При этом уведомление о недоступности прокси ноды ТРК сервер офис не приходило.
Когда интернет в филиале включили то пришли уведомлении о включении интернета, доступности ноды ТРК сервер офис (прокси нода), доступности ноды ТРК KMS (нода за прокси).
Как сделать чтобы при отключении интернета приходило уведомление и о недоступности прокси ноды?Вот так выглядели уведомления:
26.Jul.2026 17:26:27
Severity Major
ТРК интернет
Node is unreachable by ICMP===========================>>> Тут не хватает уведомления о недоступности прокси ноды ТРК сервер офис
26.Jul.2026 17:26:02
Severity Critical
ТРК сервер KMS
Node unreachable because of network failure 26.Jul.2026 18:26:57
Severity Normal 🟢
ТРК интернет Роктел
Node started responding to ICMP 26.Jul.2026 18:27:15
Severity Normal 🟢
ТРК сервер офис
Node up 26.Jul.2026 18:27:34
Severity Normal 🟢
ТРК сервер KMS
Node up -
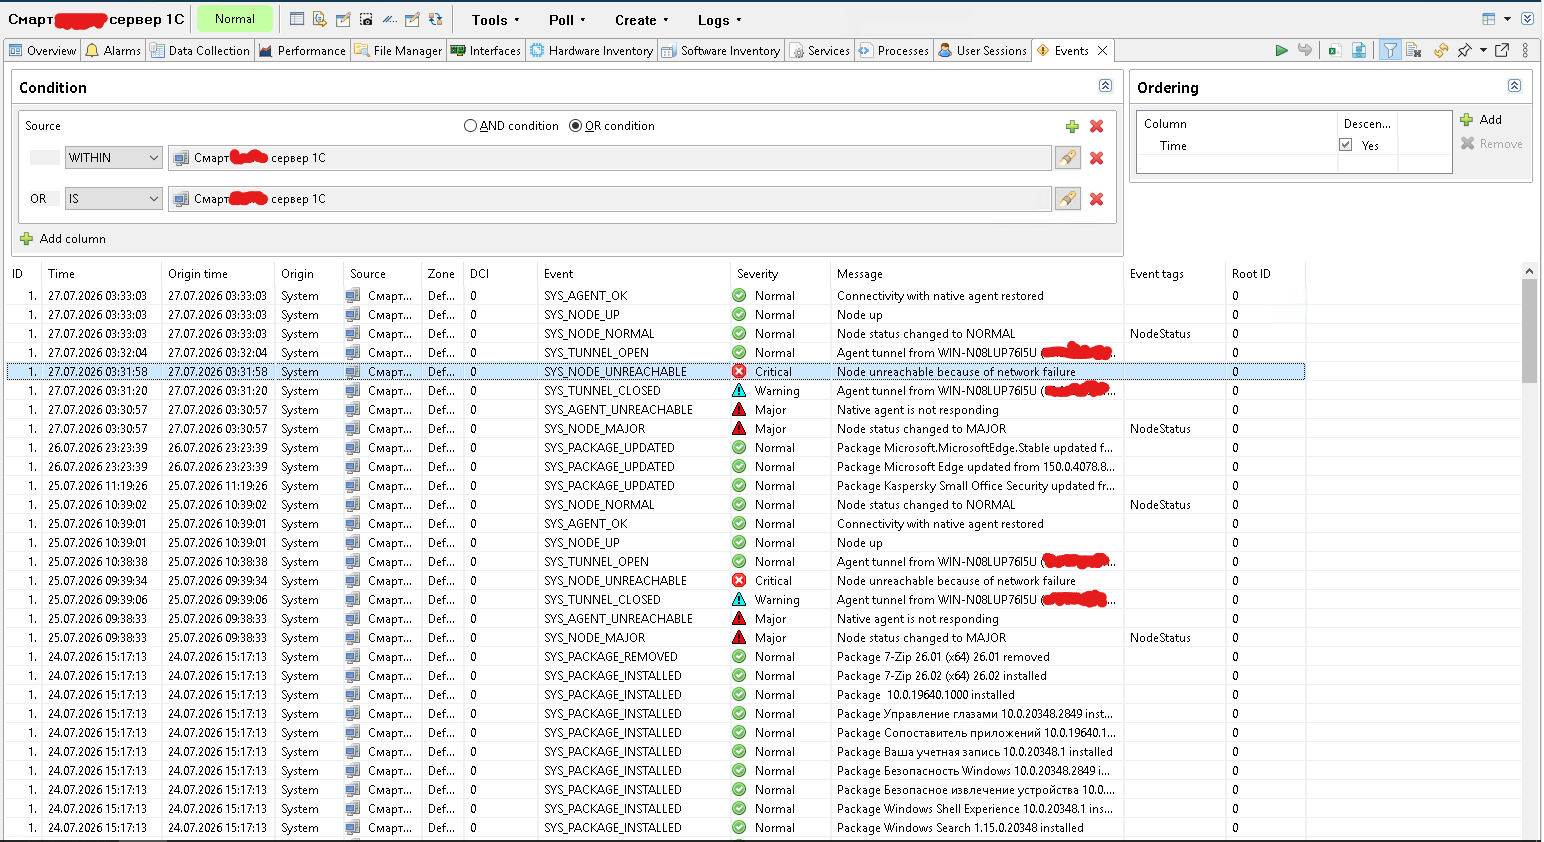
В дополнение ко всему пришло сегодня ночью одинокое уведомление
27.Jul.2026 03:33:03
Severity Normal 🟢
Смарт ******* сервер 1C
Node upУведомления о недоступности этой ноды не было. Эта нода включена в шаблон Node by tunnel epp. Нода не является прокси но подключена через тунель
-
Прикладываю лог событий с нод ТРК сервер офис и Смарт ****** сервер 1С.
Может стоит включить в правило 31 Mail alarm when node connected by tunnel / proxy node is down 300 sec (Уведомление по почте если нода подключенная через тунель / прокси нода недоступна в течении 300 сек)
событие SYS_NODE_UNREACHABLE?
Hello! It looks like you're interested in this conversation, but you don't have an account yet.
Getting fed up of having to scroll through the same posts each visit? When you register for an account, you'll always come back to exactly where you were before, and choose to be notified of new replies (either via email, or push notification). You'll also be able to save bookmarks and upvote posts to show your appreciation to other community members.
With your input, this post could be even better 💗
Register Login