
Шквал оповещений после кратковременной потери контакта с прокси нодой
-
Понял.
Один нюанс: события от узлов в режиме обслуживания тоже считаются коррелированными, поэтому правило с включённым флагом будет срабатывать и во время maintenance. Если это нежелательно, добавьте в фильтрующий скрипт правила проверку [tt]return !$object->isInMaintenanceMode;[/tt] (это атрибут, без скобок).
Опробую это. Отпишу
-
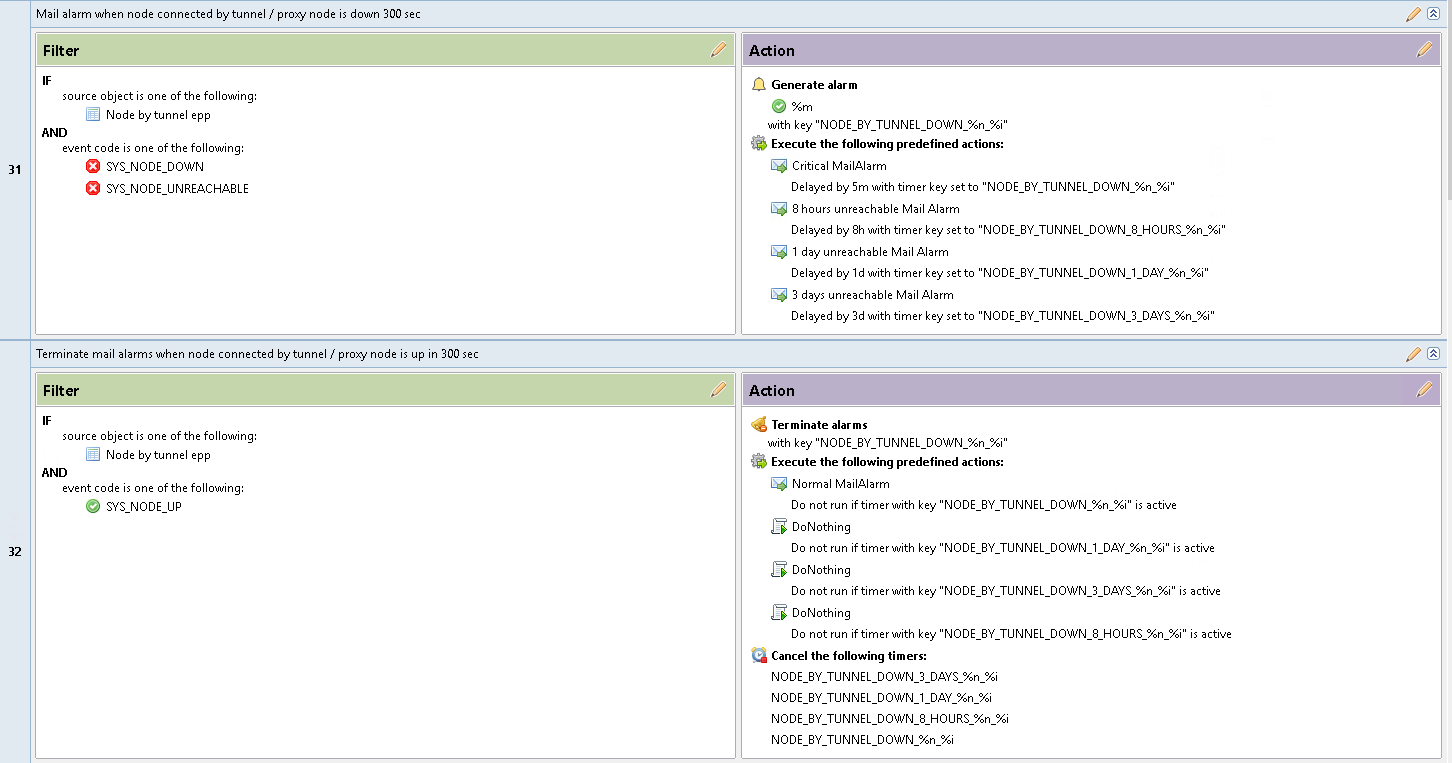
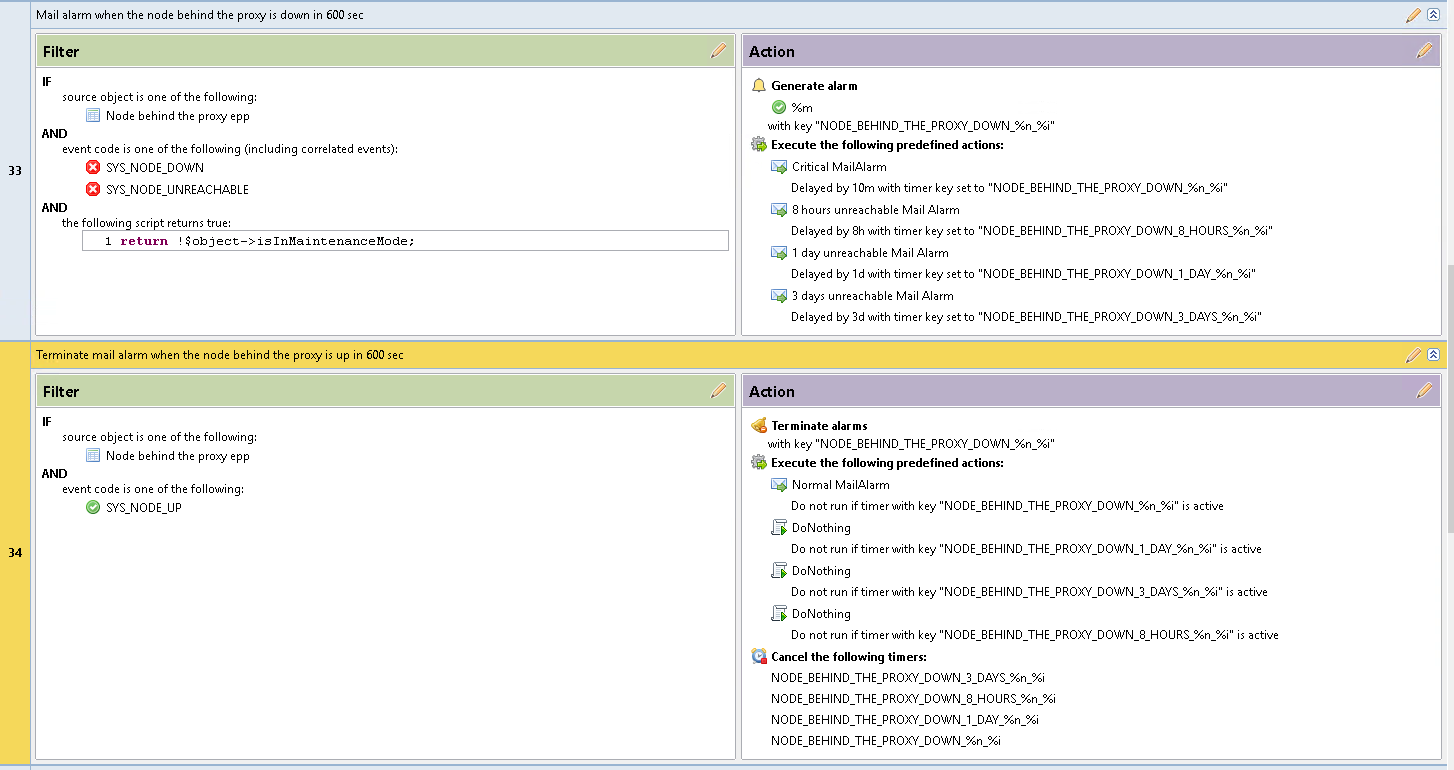
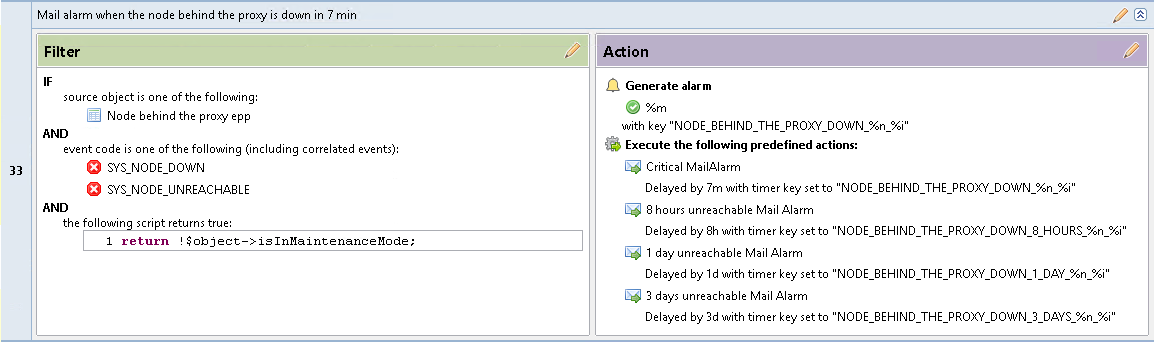
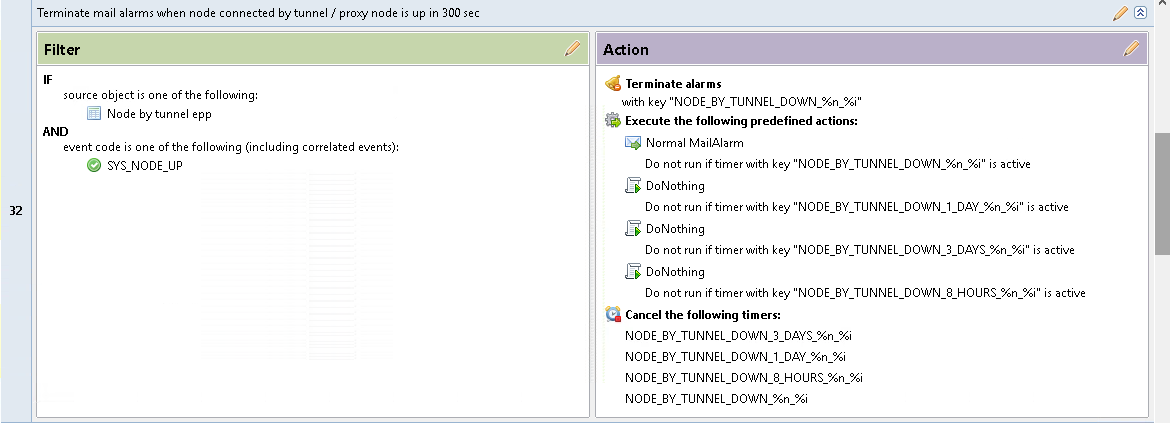
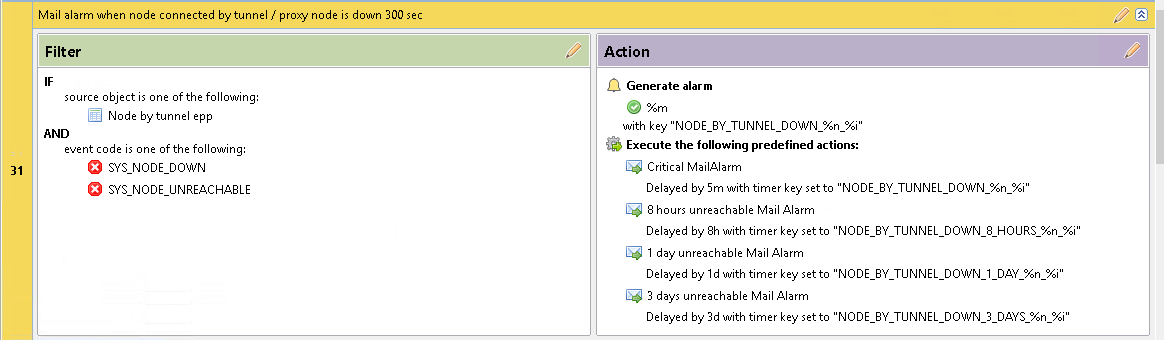
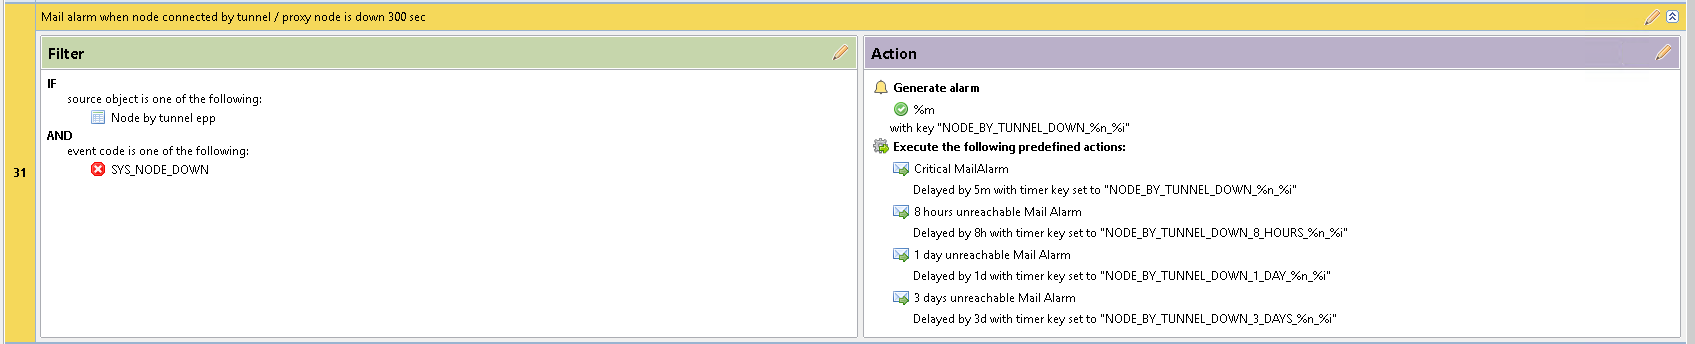
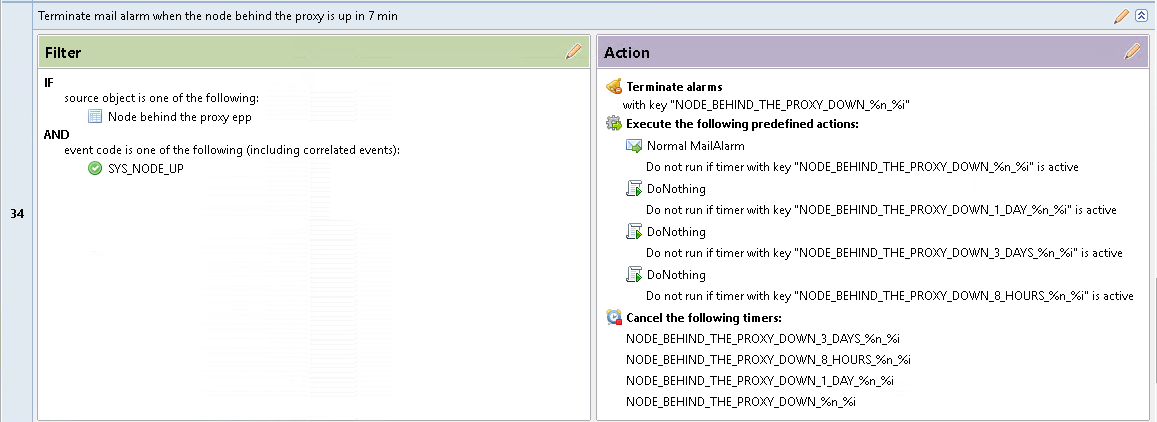
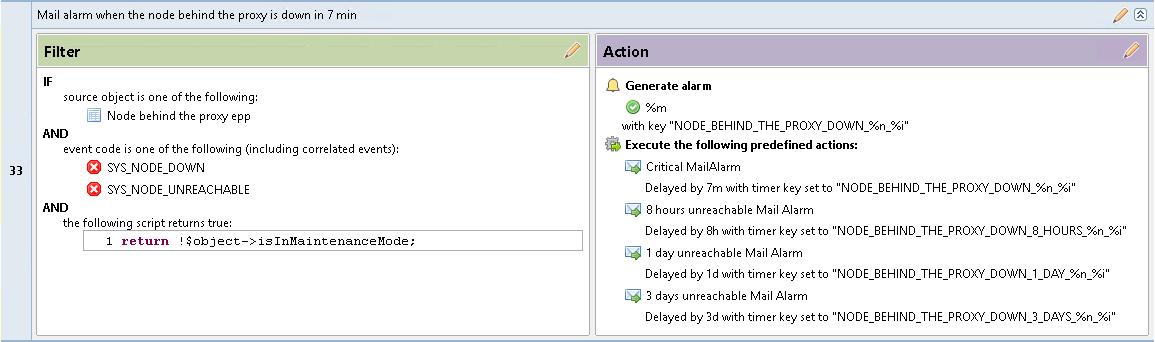
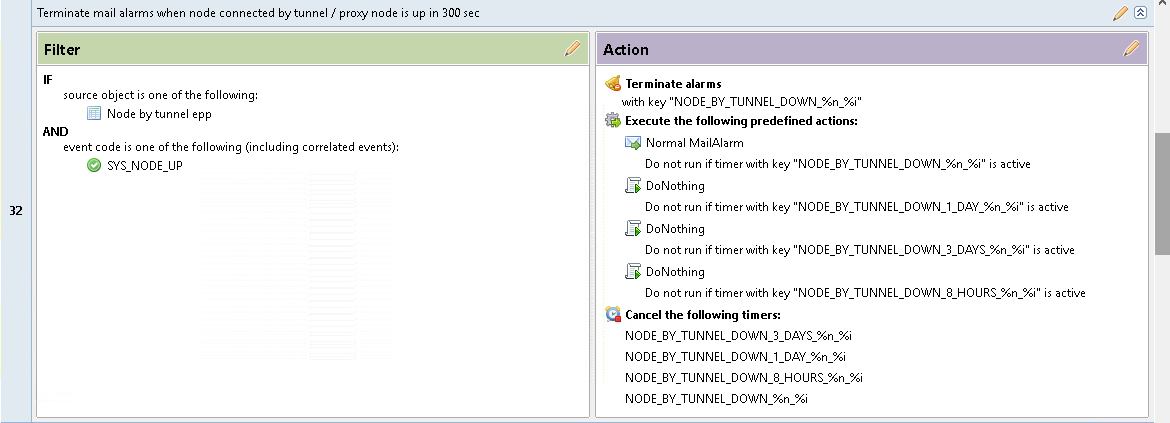
С учетом полученной информации получились такие правила.
Опцию "Accept correlated events" включал только на правиле 33 Mail alarm when the node behind the proxy is down in 600 sec (или Уведомление по почте при отключении ноды за прокси-сервером в течение 600 секунд).
Пока еще проверяю во всех режимах
-
-
Можно обойтись одной парой. Ключи таймеров и алармов у вас содержат %n_%i, то есть уникальны для каждой ноды — при объединении правил конфликта не будет.
Флаг "Accept correlated events" не переключает правило в другой режим, он только дополнительно разрешает коррелированные события. Некоррелированные обрабатываются в любом случае. Собственное SYS_NODE_DOWN прокси-ноды некоррелированное, SYS_NODE_UNREACHABLE ноды за прокси — коррелированное, поэтому одно правило с включённым флагом покрывает оба случая.
Чтобы слить 31/33 в одно правило: в фильтре указать обе группы (Node by tunnel epp и Node behind the proxy epp) или вообще убрать фильтр по объектам, включить "Accept correlated events", оставить скрипт с проверкой maintenance. То же самое с 32/34.
Две пары имеет смысл держать в двух случаях:
- нужны разные задержки — сейчас у вас 5 минут для прокси и 10 для подчинённых нод; в одном правиле останется одна;
- нужно ограничить действие флага узким списком нод. SYS_NODE_UNREACHABLE коррелируется не только при падении прокси, но и при падении маршрутизатора или коммутатора на пути. Правило с флагом, охватывающее все ноды, при падении коммутатора сработает на каждой ноде за ним — вместо одного письма о коммутаторе придёт письмо на каждую недоступную ноду. Пока в группах только ноды за прокси, этого не случится, но при расширении фильтра на всё дерево — случится.
Отдельно про правила 32/34 (Node up). SYS_NODE_UP не коррелируется никогда, кроме одного случая: все события от объекта в maintenance mode считаются коррелированными. Отсюда сценарий: нода упала (таймеры созданы), после этого её перевели в обслуживание, она поднялась — правило Node up событие пропустит, аларм не закроется и отложенные действия не отменятся, и через 8 часов придёт письмо о недоступности уже работающей ноды. Так что на правилах Node up флаг "Accept correlated events" лучше тоже включить — во всех остальных ситуациях он там ни на что не влияет.
-
С учетом полученной информации оставлю 2 пары правил.
На все ноды правила распространять не буду так как не по всем нужны уведомления.
Я правильно понял что при таком раскладе на всех 4 правилах нужно включить опцию приема кореллированных событий и скрипт с проверкой maintenance? -
Не на всех — иначе сломается сценарий с maintenance, который чинили выше. По правилам:
- 33 (нода за прокси, down) — флаг ON + скрипт maintenance
- 31 (прокси, down) — ни флага, ни скрипта
- 32 / 34 (up) — флаг ON, скрипт не добавлять
Почему по-разному:
Down. У ноды за прокси событие SYS_NODE_UNREACHABLE коррелированное — без флага правило 33 не сработает вообще. Раз флаг включён, правило начнёт срабатывать и во время обслуживания, поэтому там нужен return !$object->isInMaintenanceMode;. У прокси собственное SYS_NODE_DOWN некоррелированное, обрабатывается и без флага; а в режиме обслуживания его события становятся коррелированными, и правило само их пропустит — ни скрипт, ни флаг там не нужны.
Up. SYS_NODE_UP коррелируется только когда нода в maintenance — и это ровно тот случай, ради которого флаг включается: нода поднялась в обслуживании, правило должно пропустить событие, закрыть аларм и снять отложенные действия. Если добавить туда проверку maintenance, правило пропустит это событие мимо, аларм не закроется, и через 8 часов придёт письмо о работающей ноде — вернётся исходный баг.
-
-
-
Да, всё верно — по всем четырём флаг и скрипт стоят правильно:
- 31 (прокси down) — флаг выключен, скрипта нет
- 32 (прокси up) — флаг включён, скрипта нет
- 33 (нода за прокси down) — флаг включён + скрипт maintenance
- 34 (нода за прокси up) — флаг включён, скрипта нет
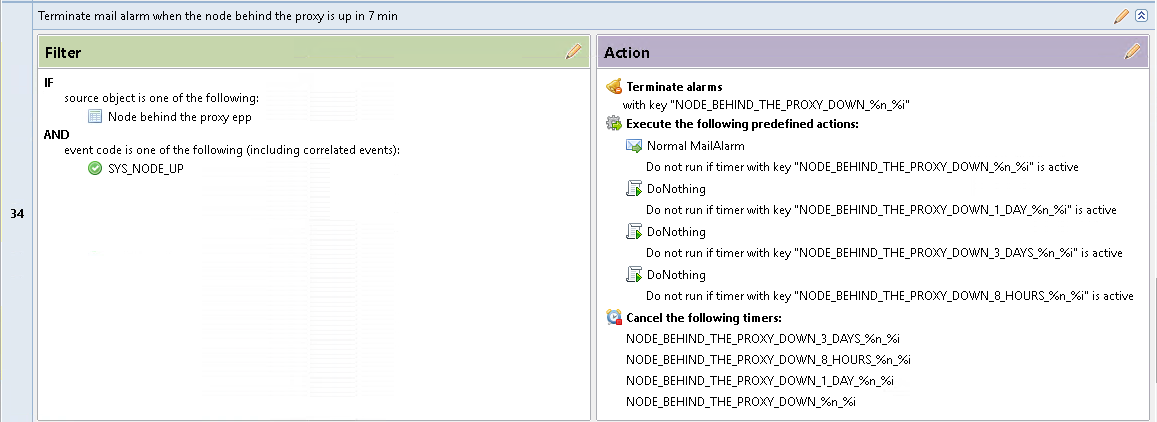
Ключи таймеров и алармов между парами согласованы (NODE_BY_TUNNEL_DOWN_* в 31/32, NODE_BEHIND_THE_PROXY_DOWN_* в 33/34), а Terminate alarms и Cancel timers в up-правилах перекрывают все ключи из down-правил. Работать будет как задумано.
Одна мелочь, ни на что не влияет: в фильтре правила 31 рядом с SYS_NODE_DOWN стоит SYS_NODE_UNREACHABLE. Для ноды, подключённой напрямую по тоннелю, недоступность — это SYS_NODE_DOWN; SYS_NODE_UNREACHABLE у неё не возникает, а если бы возникло — оно коррелированное и при выключенном флаге всё равно было бы пропущено. Можно оставить как есть.
-
-
Если применить этот подход к другим правилам самописным. Имеется 2 правила цель которых уведомлять что пинг на wan ip адрес роутера филиала стал недоступен.
Правило Правило 25 Mail alarm when Internet is not responding in 90 sec (Уведомление по почте что интернет недоступен через 90 сек)
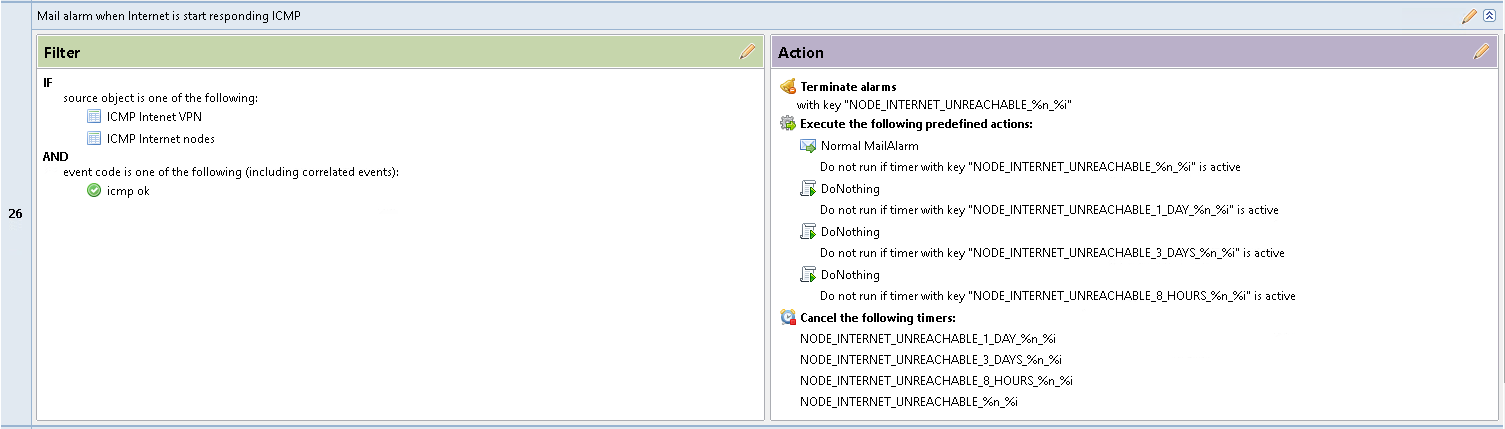
Правило 26 Mail alarm when Internet is start responding ICMP (Уведомление по почте что интернет стал доступен).
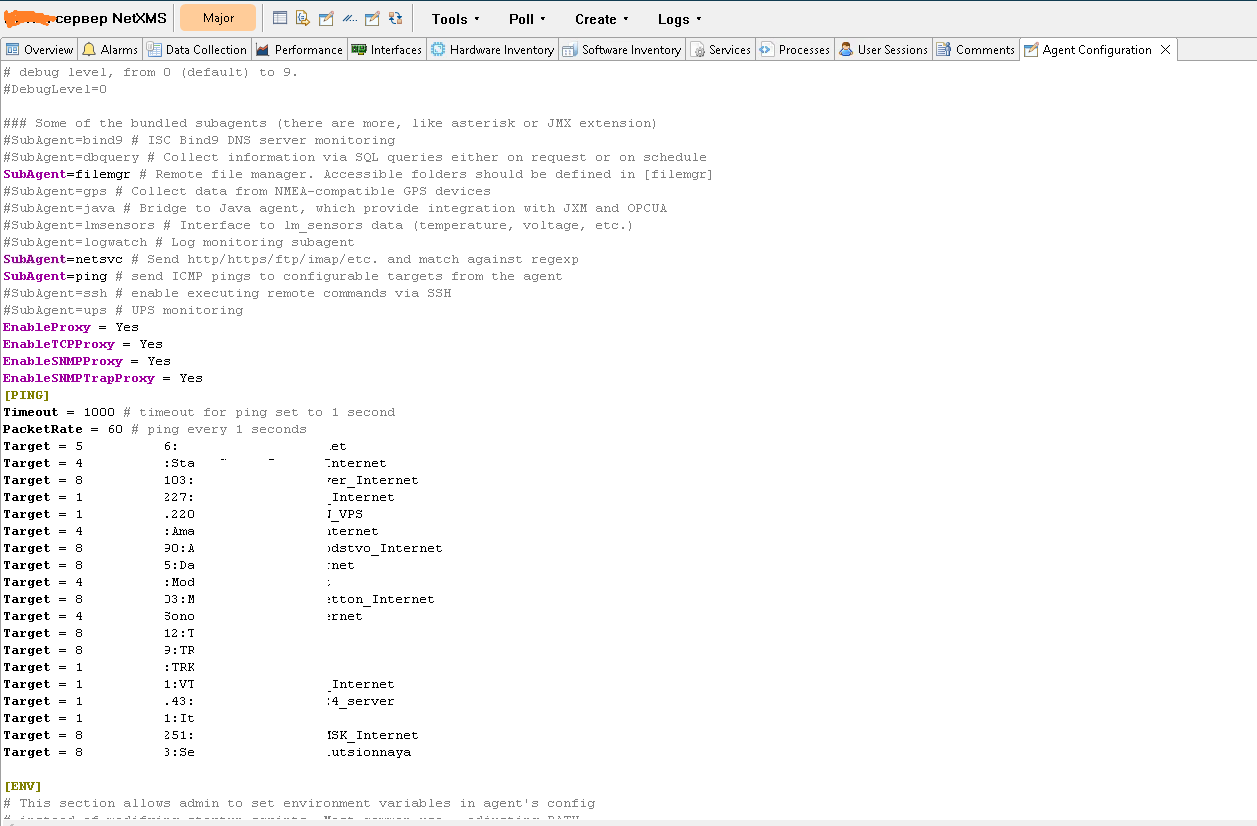
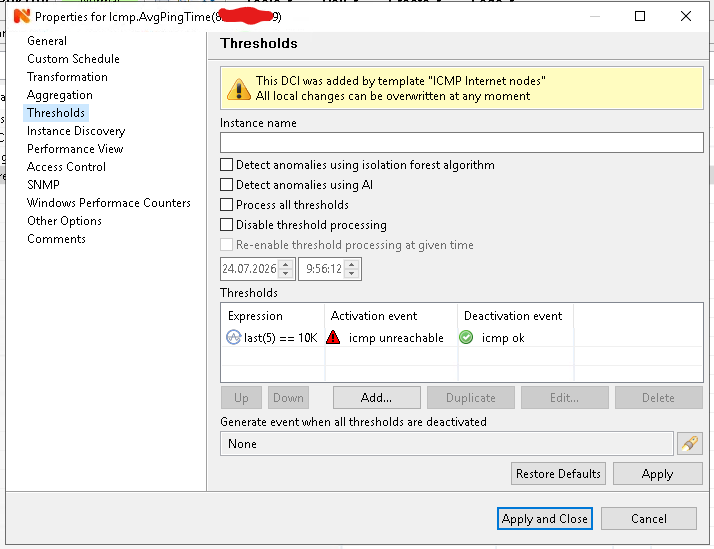
Wan ip адреса роутеров пингую через субагент ping с сервера netxms и шаблоном распространяю на нужные ноды.Вопрос: с учетом полученной информации выше я включил прием кореллированных событий только на правиле 26 Mail alarm when Internet is start responding ICMP. Это верный подход?

-
Да, подход верный. Ваши icmp unreachable / icmp ok — кастомные события, а для кастомных событий корреляция существует ровно в одном случае: когда нода-источник в режиме обслуживания (там коррелируются вообще все её события). К падению ноды, прокси или коммутатора сервер их никогда не привязывает — это делается только для фиксированного списка системных событий (SYS_ICMP_UNREACHABLE, SYS_INTERFACE_DOWN и т.д.).
Поэтому пара 25/26 — тот же случай, что 31/32, и логика распределяется так же:
- Правило 25 без флага: в нормальной работе события некоррелированные, правило срабатывает всегда. В maintenance они становятся коррелированными, и правило само их пропустит — скрипт с проверкой не нужен.
- Правило 26 с флагом: нужен ровно для сценария «интернет упал (аларм создан, таймеры 8h/1d/3d заведены) → ноду перевели в обслуживание → интернет восстановился». Без флага icmp ok будет пропущено, аларм останется висеть, и через 8 часов придёт письмо о недоступности уже работающего интернета.
Одно замечание на будущее: системное SYS_ICMP_UNREACHABLE при падении ноды коррелируется к её SYS_NODE_DOWN, а ваш кастомный icmp unreachable — нет. Если нода, на которой висит этот DCI, упадёт целиком, придут оба уведомления — и о ноде, и об интернете. Для порогов с кастомными событиями корреляция такие следствия не гасит.
-
Одно замечание на будущее: системное SYS_ICMP_UNREACHABLE при падении ноды коррелируется к её SYS_NODE_DOWN, а ваш кастомный icmp unreachable — нет. Если нода, на которой висит этот DCI, упадёт целиком, придут оба уведомления — и о ноде, и об интернете. Для порогов с кастомными событиями корреляция такие следствия не гасит.
--------------
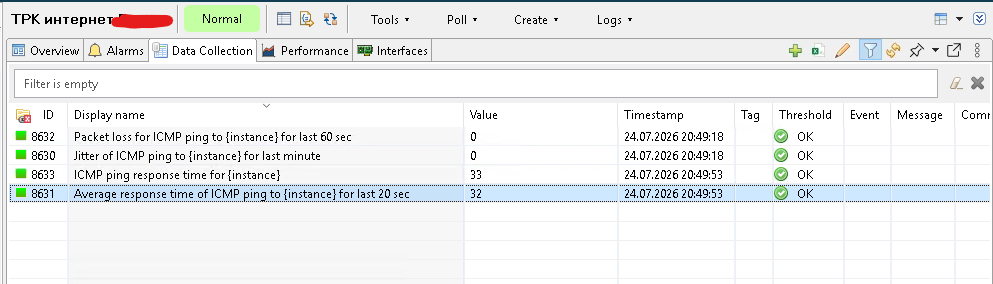
Это правило висит на ноде "Интернет название филиала". Завел отдельную ноду которую так обозвал. И так с каждым внешним ip адресом филиала.
Прокси нода и другие сервера выделены в отдельные ноды. Цель: получение отдельных уведомлений о недоступности интернета в филиалах и серверов в этих филиалах. Есть филиалы с основным и резервным интернетом, есть те у кого проблемы с электропитанием.
-
Что-то не так работает как ожидалось.
Было отключение интернета в филиале с 17.26 до 18.26 26.07.2026.
Пришло уведомление об отключении интернета и уведомление о недоступности ноды ТРК KMS (это нода за прокси). При этом уведомление о недоступности прокси ноды ТРК сервер офис не приходило.
Когда интернет в филиале включили то пришли уведомлении о включении интернета, доступности ноды ТРК сервер офис (прокси нода), доступности ноды ТРК KMS (нода за прокси).
Как сделать чтобы при отключении интернета приходило уведомление и о недоступности прокси ноды?Вот так выглядели уведомления:
 26.Jul.2026 17:26:27
Severity Major
ТРК интернет
 Node is unreachable by ICMP
===========================>>> Тут не хватает уведомления о недоступности прокси ноды ТРК сервер офис
26.Jul.2026 17:26:02
Severity Critical
ТРК сервер KMS
Node unreachable because of network failure 26.Jul.2026 18:26:57
Severity Normal 🟢
ТРК интернет Роктел
Node started responding to ICMP 26.Jul.2026 18:27:15
Severity Normal 🟢
ТРК сервер офис
Node up 26.Jul.2026 18:27:34
Severity Normal 🟢
ТРК сервер KMS
Node up -
В дополнение ко всему пришло сегодня ночью одинокое уведомление
27.Jul.2026 03:33:03
Severity Normal 🟢
Смарт ******* сервер 1C
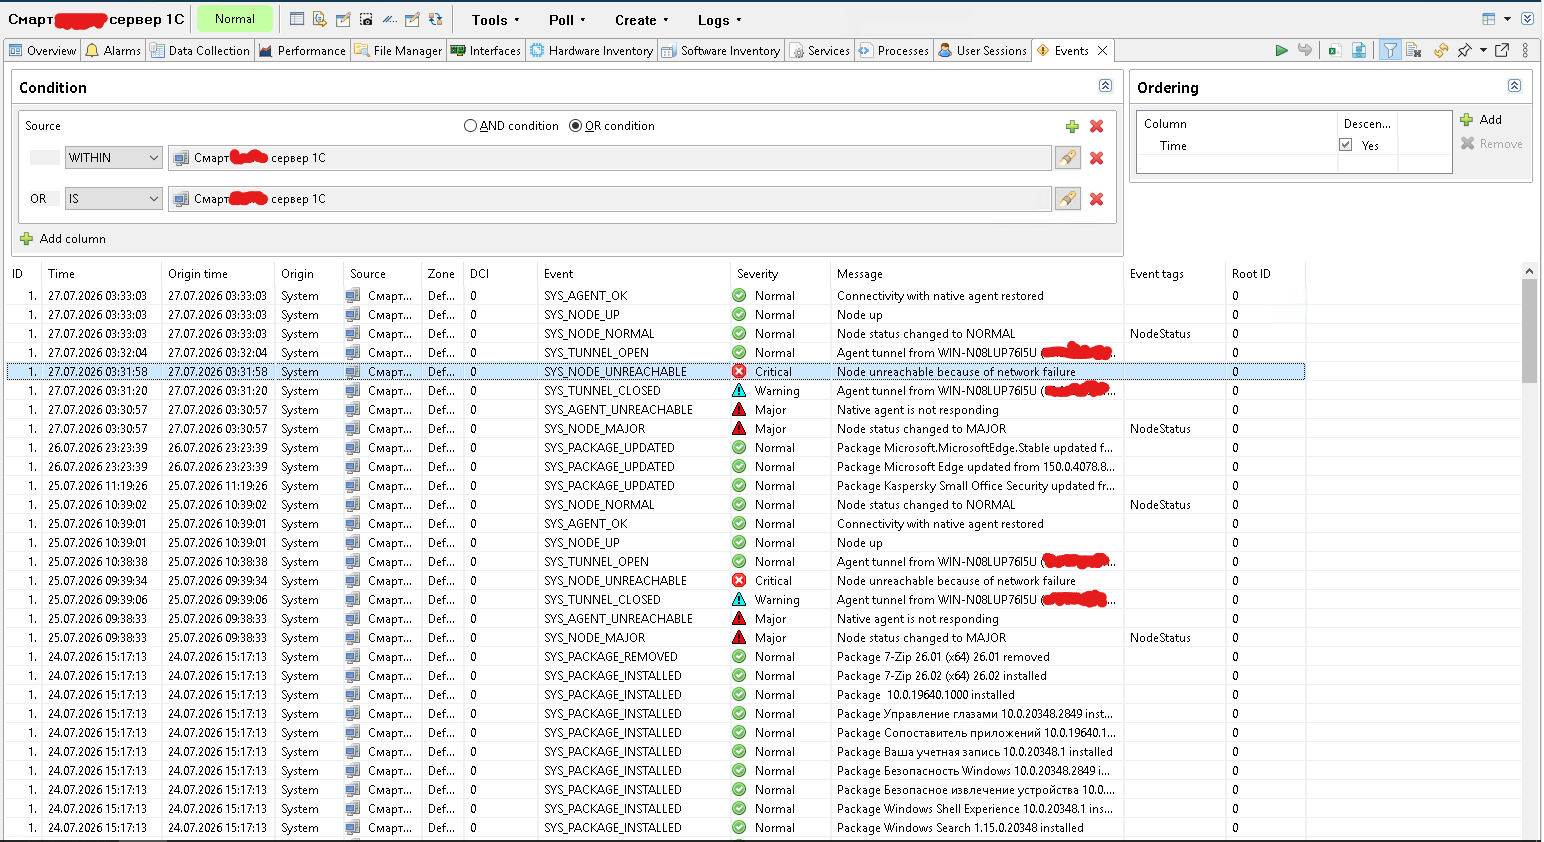
Node upУведомления о недоступности этой ноды не было. Эта нода включена в шаблон Node by tunnel epp. Нода не является прокси но подключена через тунель
-
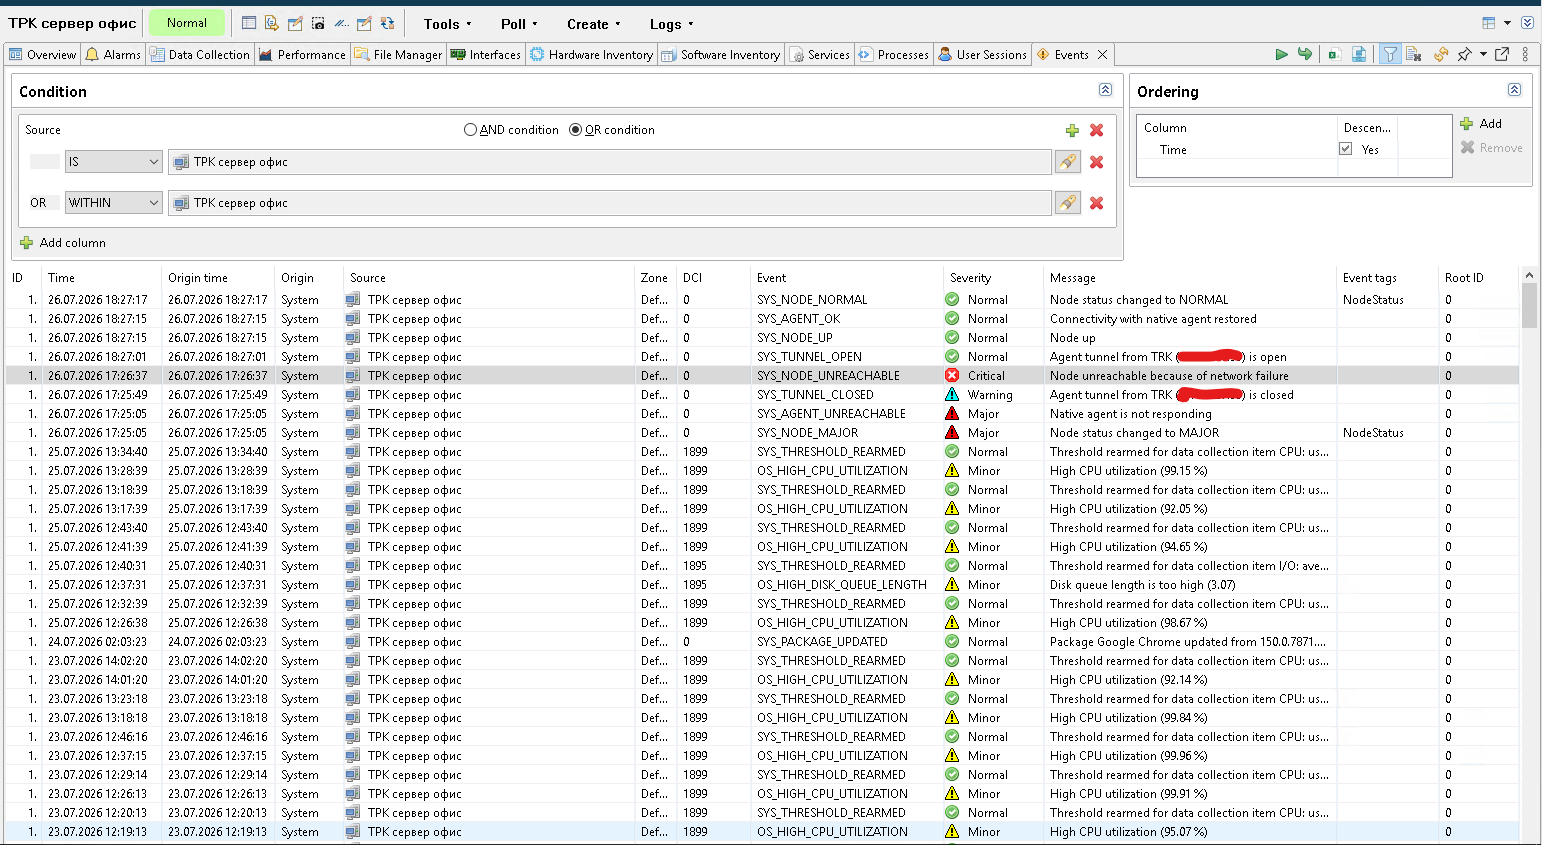
Прикладываю лог событий с нод ТРК сервер офис и Смарт ****** сервер 1С.
Может стоит включить в правило 31 Mail alarm when node connected by tunnel / proxy node is down 300 sec (Уведомление по почте если нода подключенная через тунель / прокси нода недоступна в течении 300 сек)
событие SYS_NODE_UNREACHABLE?
-
Да, SYS_NODE_UNREACHABLE в правило 31 нужно вернуть. Моё замечание от 23.07 было неверным: у нод, подключённых через тоннель, приходит именно SYS_NODE_UNREACHABLE, а не SYS_NODE_DOWN. После того как вы убрали это событие из правила 31, срабатывать ему стало не на чем.
Выбор события определяет не тоннель сам по себе, а наличие у ноды primary IP address:
- Нода без primary IP (связь только через тоннель агента). Проверка «весь узел недоступен» для неё при отвалившемся агенте не выполняется вообще. Вместо этого сервер отдельно смотрит, остался ли тоннель, и если тоннеля нет — публикует SYS_NODE_UNREACHABLE с параметром reason = "Agent tunnel disconnected". SYS_NODE_DOWN для такой ноды не возникает никогда.
- Нода с primary IP — обычная логика: SYS_NODE_DOWN, если причина в самой ноде, и SYS_NODE_UNREACHABLE с reason "Router down" / "Switch down" / "Proxy node down", если сервер нашёл причину выше по пути.
Восстановление в обоих случаях — SYS_NODE_UP. Отсюда и картина: up-уведомления приходили, down — нет.
В ваших логах это видно напрямую:
- ТРК сервер офис, 26.07: 17:25:05 SYS_AGENT_UNREACHABLE, 17:25:49 SYS_TUNNEL_CLOSED, 17:26:37 SYS_NODE_UNREACHABLE, 18:27:15 SYS_NODE_UP. SYS_NODE_DOWN нет ни одного.
- Смарт сервер 1С, 27.07 03:31:58 — ровно то же самое, и 25.07 09:39:34 тоже. Так что ночное одинокое «Node up» — не отдельная аномалия, а тот же самый случай.
Что сделать: добавить SYS_NODE_UNREACHABLE в правило 31, рядом с SYS_NODE_DOWN. Больше ничего менять не нужно. Флаг "Accept correlated events" и скрипт с maintenance на правиле 31 по-прежнему не нужны: SYS_NODE_UNREACHABLE с reason "Agent tunnel disconnected" не коррелируется (у этих событий в вашем логе Root ID = 0), а в режиме обслуживания события станут коррелированными и правило пропустит их само.
Перечислять оба события в правилах «нода недоступна» стоит всегда — стандартное правило Start downtime устроено именно так, в нём указаны и SYS_NODE_DOWN, и SYS_NODE_UNREACHABLE. Документация тоже говорит, что генерируется одно из двух, в зависимости от причины: https://netxms.org/documentation/adminguide/topology.html
Проверить, какая ветка сработала у вас: откройте SYS_NODE_UNREACHABLE в event log и посмотрите параметр reason. "Agent tunnel disconnected" — нода без primary IP, событие некоррелированное. Любой другой reason означает, что сервер нашёл причину выше по пути; из них коррелируются "Router down", "Switch down", "Proxy node down" и "Proxy agent unreachable" — эти правило 31 без флага пропустит.
Note: асимметрия между правилами 31 и 32 из-за этого остаётся. У 32 флаг включён, у 31 — нет, поэтому коррелированное событие недоступности правило 31 пропустит, а «Node up» при восстановлении придёт всё равно. Для нод без primary IP этого не случится, но если позже добавите в группу ноду за маршрутизатором или коммутатором — одинокое «Node up» вернётся.
-
Сегодня обновлял сервер netxms до версии 6.2.2. Перед обновлением перевел все ноды в режим обслуживания на 30 мин.
Сделал резервную копию вирт машины с netxms, обновил сервер. Заняло порядка 20-25 мин. После обновления пришли уведомления от некоторых нод (все подключены через тунель). Скриншот лога событий прилагаю.Вопрос: может на правиле 31 Mail alarm when the node behind the proxy is down in 7 min нужно включить скрипт проверки что нода не в режиме обслуживания?
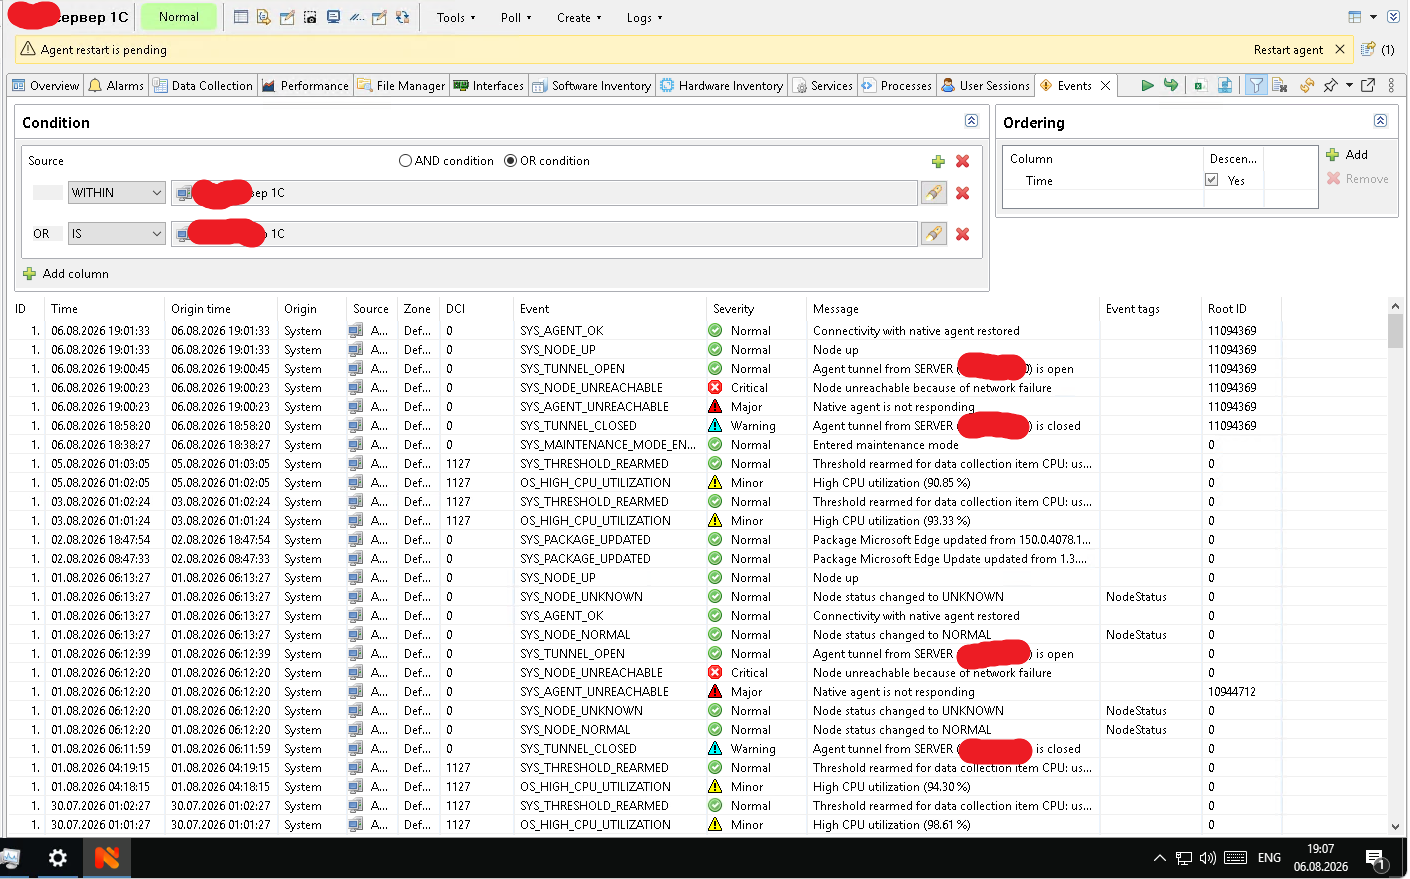
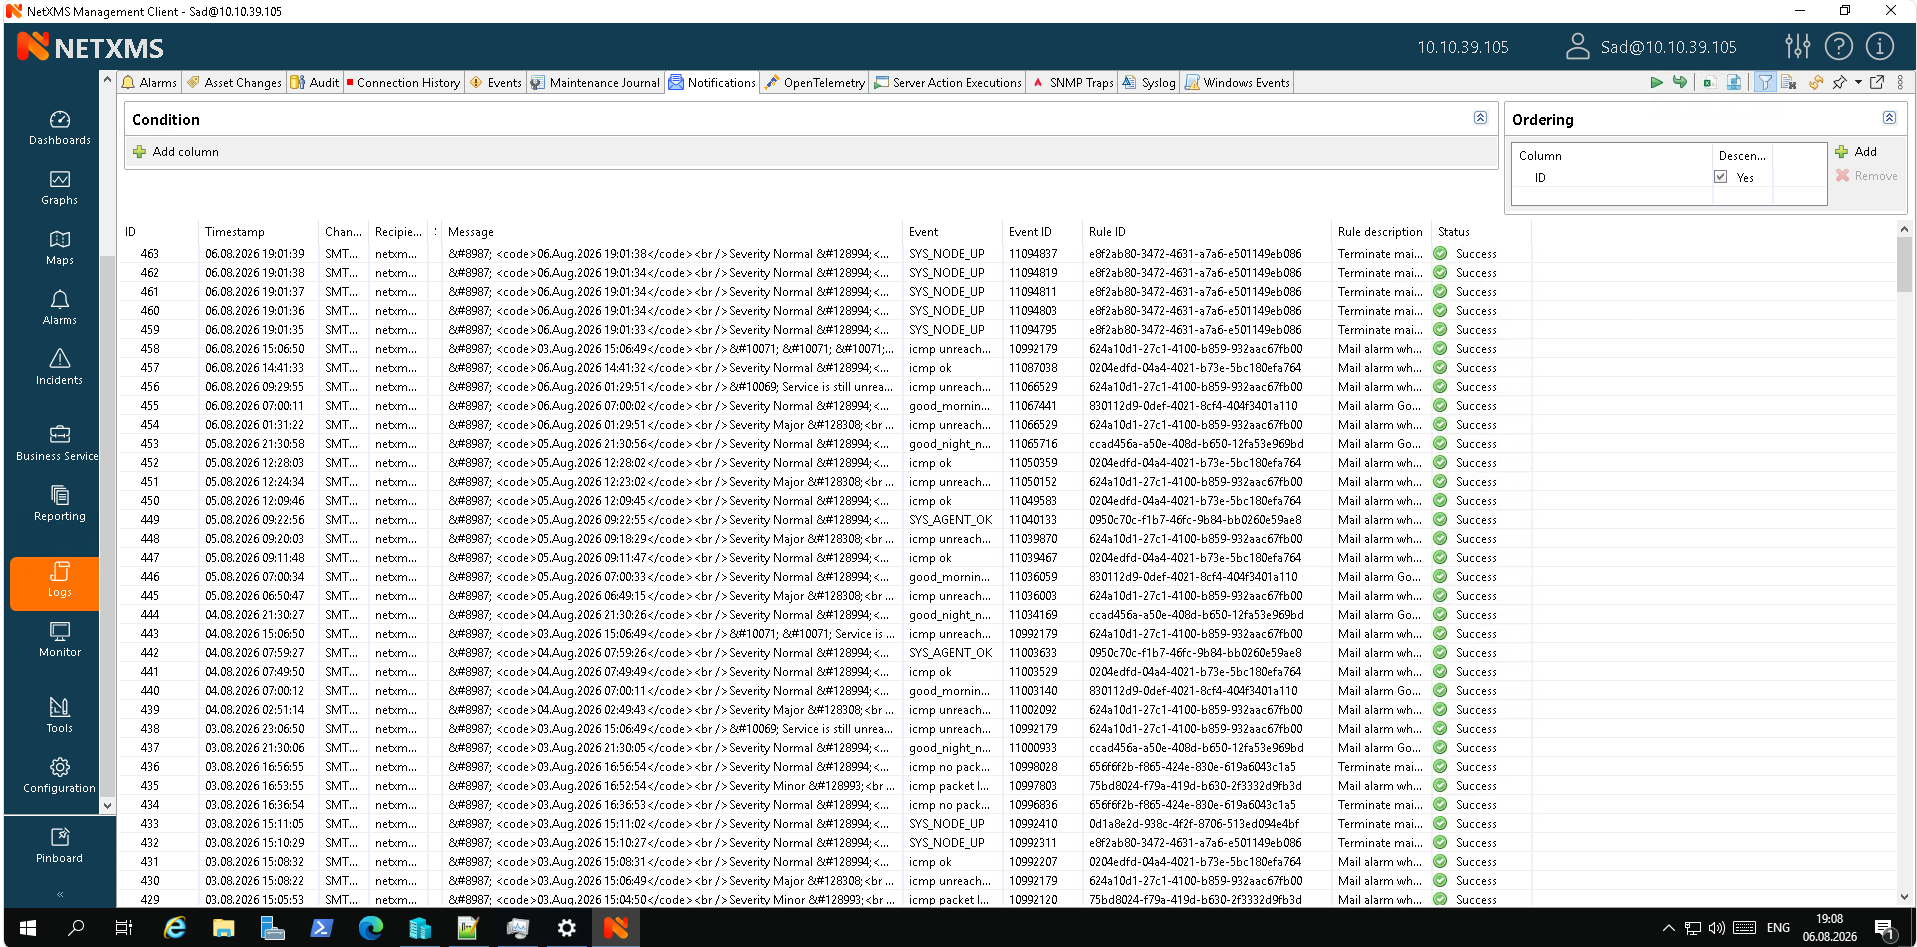
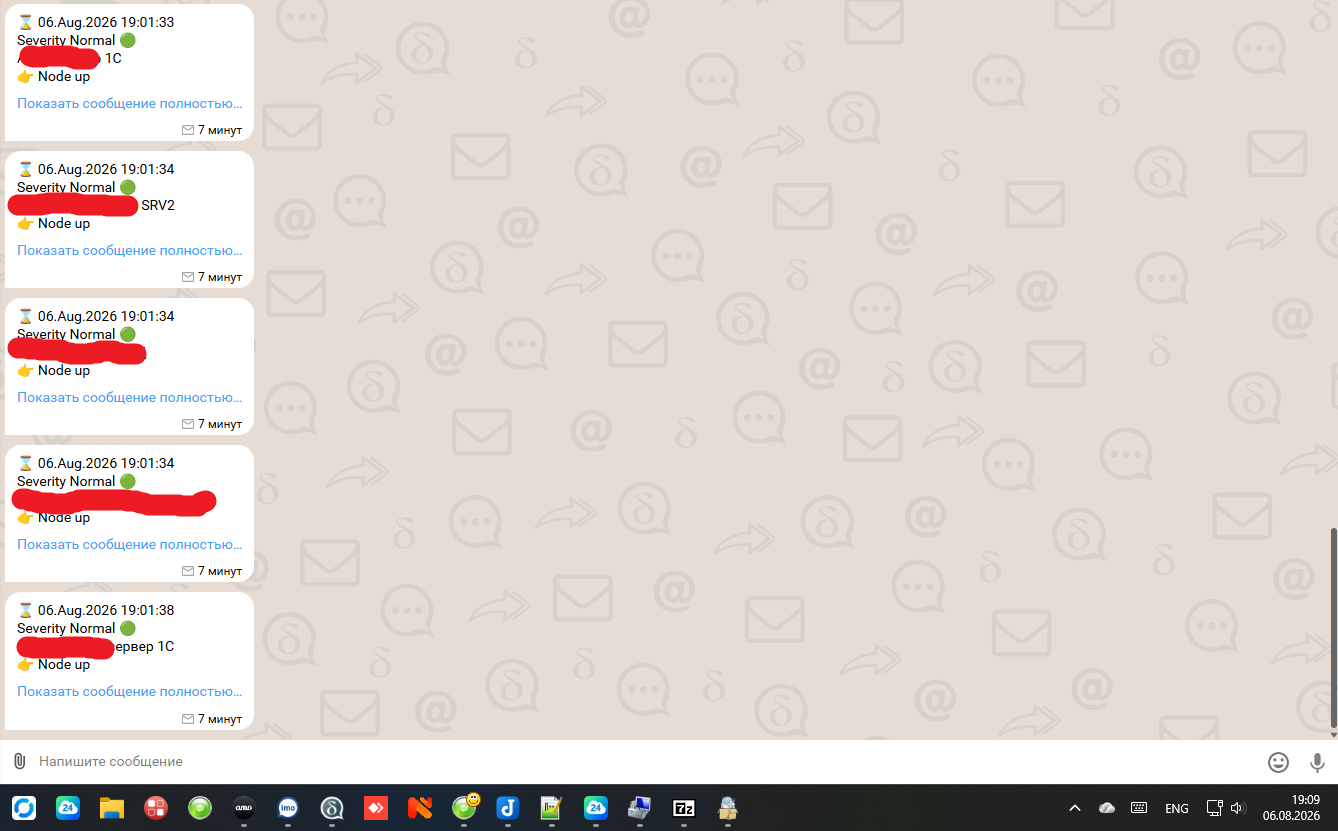
-
-
Нет, скрипт на правиле 31 ничего не изменит — правило 31 в этот раз вообще не срабатывало. Уведомления пришли от правила 32.
В логе уведомлений сервера это видно напрямую: строки 459–463 за 19:01:33–19:01:39, событие SYS_NODE_UP, Rule ID e8f2ab80-3472-4631-a7a6-e501149eb086, описание правила "Terminate mail alarms when node connected by tunnel / proxy node is up in 300 sec" — это правило 32. Пять уведомлений, все "Node up", ни одного "down".
Режим обслуживания ничего не подавляет на этапе генерации событий. События создаются, пишутся в event log и попадают в EPP как обычно; единственное, что делает maintenance — проставляет каждому событию объекта Root ID, равный ID события входа в обслуживание. Дальше решает флаг "Accept correlated events" на правилах.
В вашем логе событий: SYS_MAINTENANCE_MODE_ENTERED в 18:38:27 с Root ID = 0, а всё последующее — SYS_TUNNEL_CLOSED 18:58:20, SYS_AGENT_UNREACHABLE и SYS_NODE_UNREACHABLE 19:00:23, SYS_TUNNEL_OPEN 19:00:45, SYS_NODE_UP и SYS_AGENT_OK 19:01:33 — с Root ID = 11094369. Все коррелированные.
Отсюда цепочка:
- SYS_NODE_UNREACHABLE коррелированное, у правила 31 флаг выключен — правило его пропустило. Ни аларм, ни таймер NODE_BY_TUNNEL_DOWN_%n_%i не создались.
- SYS_NODE_UP тоже коррелированное, но у правила 32 флаг включён — правило сработало.
- У действия Normal MailAlarm в правиле 32 стоит блокировка "Do not run if timer NODE_BY_TUNNEL_DOWN_%n_%i is active". Таймера нет, потому что его никто не создавал — блокировка не сработала, письмо ушло.
Что сделать: выключить "Accept correlated events" на правилах 32 и 34. Скрипт с проверкой maintenance добавлять никуда не нужно — он дал бы тот же результат, но флаг проще.
Здесь нужно поправить то, что я писал 21.07. Флаг на up-правилах рекомендовался ради сценария "нода упала (таймеры заведены) → её перевели в обслуживание → она поднялась в обслуживании → аларм не закрылся, и через 8 часов пришло письмо". Этот сценарий сервер закрывает сам: при выходе из обслуживания состояние ноды восстанавливается на то, каким оно было до входа, и если оно разошлось с фактическим — принудительно запускается status poll. В этом сценарии состояния разойдутся, поллинг отработает и сгенерируется новое, уже некоррелированное SYS_NODE_UP: правило 32 на нём сработает, аларм закроется, таймеры снимутся. Флаг для этого не нужен, а его единственный реальный эффект — ровно то, что вы получили 06.08.
Два соседних случая, чтобы было понятно, чего ждать после выключения флага:
- Нода и упала, и поднялась внутри окна обслуживания (ваш случай 06.08). Состояние на выходе совпадает с исходным, поллинг не форсируется, после выхода из обслуживания ничего не приходит. Аларма и таймеров при этом не создавалось — закрывать нечего.
- Нода упала в обслуживании и осталась лежать. Состояния разойдутся, форсированный поллинг отработает, и SYS_NODE_UNREACHABLE придёт уже некоррелированным — реальную аварию за окном обслуживания вы не потеряете.
Вне обслуживания SYS_NODE_UP не коррелируется никогда, поэтому на обычную работу правил 32/34 выключенный флаг не влияет.
Правила 31 и 33 трогать не нужно. У 31 флаг выключен, у 33 включён вместе со скриптом проверки maintenance — оба во время обслуживания молчат.
Note: одна дырка остаётся. Отложенные действия, заведённые до входа в обслуживание, во время обслуживания не отменяются и не проверяют maintenance при срабатывании — их снимет только SYS_NODE_UP после выхода. У вас Critical MailAlarm стоит с задержкой 5 минут, поэтому сценарий "нода упала, её в течение 5 минут перевели в обслуживание, и там же она поднялась" всё равно даст письмо о недоступности. Задержки 8h/1d/3d сработают только если окно обслуживания окажется длиннее них.
Отдельно: в моём ответе от 28.07 было сказано, что асимметрия между правилами 31 и 32 проявится только если в группу добавить ноду за маршрутизатором или коммутатором, и что для нод без primary IP этого не случится. Это неверно — режим обслуживания коррелирует все события объекта независимо от primary IP и от топологии, поэтому асимметрия проявляется в любое окно обслуживания. Ровно это 06.08 и произошло.
То, что maintenance подавляет события через корреляцию, а не отдельным механизмом, в трекере уже разбиралось: https://github.com/netxms/netxms/issues/2571 — закрыто как expected behavior, с тем же обходным путём через скрипт. В документации раздел про maintenance mode при этом сформулирован неверно: там сказано, что события не генерируются, тогда как они генерируются и коррелируются. Завёл тикет: https://github.com/netxms/netxms-doc/issues/63

Hello! It looks like you're interested in this conversation, but you don't have an account yet.
Getting fed up of having to scroll through the same posts each visit? When you register for an account, you'll always come back to exactly where you were before, and choose to be notified of new replies (either via email, or push notification). You'll also be able to save bookmarks and upvote posts to show your appreciation to other community members.
With your input, this post could be even better 💗
Register Login